Strata検証①:NVIDIA RTX 3060/12GB x2 = 24GB の中古GPUで OpenCode v2 + Qwen3.8-Flash-Next のAIエージェント開発が実用的速度で実現!
Strataは、Qwen3.8-Flash-Nextという大規模モデルを、12GBのGPUを搭載したPCでも動かせるようにする推論エンジンです。GPU・CPU・メインメモリー・SSDにデータと計算を分担させ、GPUのメモリー容量を超えるモデルを扱います。
Flash-Nextは、本体125BにPLEと呼ばれる埋め込みテーブル51Bを加えた、176B相当のモデルです。量子化せずBF16で全重みを保持すれば、単純計算で約352GBになります。これまで当ラボでは、本体の量子化とPLEのSSD配置を組み合わせ、128GBのDGX Sparkや、GPUへ96GBを割り当てたEVO-X2で動かしてきました。
Strataはさらに、本体のexpert計算をCPUとGPUで分担し、よく使うexpertをGPUへキャッシュします。大容量メモリー機で使っていたモデルを、12GBの民生用GPUでも扱える。ここが、今回試してみたくなったところです。
今回は、中古でも入手しやすい NVIDIA GeForce RTX 3060 12GBを2枚使いました。合計24GBのVRAMをCPU・RAMと組み合わせ、Flash-Nextを長文処理やOpenCode v2の実作業にどこまで使えるかを検証します。
Flash-Nextを選んだ理由は、これまでの実作業試験で、調べてから判断する力を見せてくれたからです。
OpenCodeと7モデルを組み合わせた過去の比較では、ファイルサーバを調査し、運用上の制約に合わせて設計する3課題で、Flash-Nextが45点満点を取りました。たとえば、SELinuxのポリシーをソースまで読み、実際の実行条件も再現して、予定していた方法ではファイルを読めないことを設計段階で見つけています。[14]
私がローカルのエージェントに任せたいのは、こういう仕事です。資料やコードを読み、必要なところを実機で確かめ、分かったことを次の判断へつなげてほしい。そのモデルを、手元のRTX 3060でも使いたいと思いました。
なお、過去の7モデル比較はDGX Spark上のNVFP4とOpenCode 1.18.25で行ったものです。今回のIQ3_S・OpenCode v2.0.24とは条件が異なるため、過去の満点を今回の構成の品質保証には使いません。今回も改めて課題を解かせて確認します。
では、そのモデルはどれくらい大きいのでしょうか。公式表記は125B-A6Bです。MoE本体は125Bありますが、毎トークンの計算に使うのは6Bで、さらに51BのPLEが付いています。本稿の「176B相当」はこの合計です。投機デコード用のMTP 4Bは含めておらず、こちらも数えると180Bになります。[13]
冒頭の約352GBは、176BにBF16の2バイトを掛けた、重みだけの単純計算です。実行時にはKVキャッシュや作業領域も必要になります。
| 内訳 | パラメータ数 | BF16で保持する単純計算 |
|---|---|---|
| MoE本体 | 125B | 約250GB |
| PLE | 51B | 約102GB |
| 合計(MTPを除く) | 176B | 約352GB |
GBは10進表記です。量子化後の実容量には形式や付加情報の影響があり、各部品を同じビット数にするとも限りません。MoEの「毎回6Bだけ使う」は計算量の話で、残りの重みを保存しなくてよいという意味ではありません。
ここで効くのがFlash-Nextの構造です。PLEは、トークンの並びを手掛かりに行を引く、大きな参照表です。表全体は巨大でも、各トークンで読むのはごく一部なので、SSDに置いて必要な行だけ読む方法が使えます。本体の量子化で容量を減らし、PLEのSSD配置でメモリーに常駐させる量を減らす。この2つを組み合わせるのが、大きなモデルを扱う出発点です。[11][13]
さらに、48層のうち36層はGated DeltaNet、12層はQwen Sparse Attentionというハイブリッド構成で、通常のattentionのKV cacheを全層に持つ構成より、長文時のメモリー増大を抑えやすくなっています。長い文脈を使うエージェント用途でも、この設計が重要になります。[11][13]
以前の検証では、DGX Sparkの128GB統合メモリーで、NVFP4を中心とした混合量子化とPLEのSSD配置を使いました。1件ずつ処理する条件で約27 tok/sを得ています。[11]
EVO-X2では、総RAM 128GBのうち96GBをGPUへ割り当て、残りをシステム側で使う構成にしました。llama.cppのVulkanバックエンドとUD-IQ4_XSを使い、本体約66GBをGPU側へ、PLE約29GBをSSD側へ置いています。1件ずつの生成は約20 tok/sで、短い~中程度の会話では実用的な速度でした。ただし、当時は約10万tokens前後の長文でシステムがリセットされ、長文の実作業には課題が残りました。[12]
| これまでの構成 | モデルを収める主な工夫 | 当時確認した生成速度 |
|---|---|---|
| DGX Spark:128GB統合メモリー | 本体の混合量子化+PLEのSSD配置、SGLang | 約27 tok/s |
| EVO-X2:総RAM 128GB、GPU割当96GB | UD-IQ4_XS+PLEのSSD配置、llama.cpp Vulkan | 約20 tok/s |
過去記事の1件ずつ処理する条件を紹介したものです。後述するStrataとは量子化・入力・測定方法が異なり、速度順位や倍率を求める比較表ではありません。
この2台では、量子化後も数十GBある本体を、GPUからアクセスできる大容量メモリーへ置いていました。Strataでは、その本体のexpert計算をCPUにも分担させます。GPUに載せる量を絞りながら、PC全体で推論を進める仕組みです。[1][2]
これなら、一般的なデスクトップPCと12GB GPUでも手が届きます。本稿ではRTX 3060を2枚使い、長文を読めるか、エージェントとして課題を完了できるかまで確認します。
Strataは、Niko1221氏がMITライセンスで公開しています。OpenAI/Anthropic互換APIを備え、OpenCodeなどの外部クライアントから利用できます。なお、モデルのライセンスはエンジンとは別です。[1][2]
最初の公式リリースv0.1.0は2026年9月24日17:05 UTC、日本時間では9月25日02:05に公開されました。私は10月5~7日に今回の2GPU構成で導入・調整・長文品質試験を行い、10月8~9日には別の量子化とSSD mmap構成も検証しました。10月21日には、既存モデルと旧環境を残したまま、新旧engineの比較まで完了しています。[3][9]
本稿では、まず仕組みと2GPU構成の考え方を整理し、その後に実測結果と限界を示します。中古価格や購入額の比較は行っていないため、価格性能比の優劣までは評価していません。
LLMを複数GPUで動かす手法自体は、Strata以前からあります。ここは「モデルをどう分けるか」と「どの装置で計算するか」を分けると理解しやすくなります。
まず、一般的なDenseモデルにも使えるのが層の分割です。前半の層をGPU A、後半をGPU Bへ置き、中間結果を次のGPUへ渡します。1つのリクエストは担当層を順に通るため、GPUが2枚になっても、1トークンの処理が単純に半分の時間になるわけではありません。
Tensor Parallelismでは、層の内部にある重みや行列演算を分け、複数GPUで計算します。分割の仕方に応じて途中結果の交換や集約が必要で、通信性能が効きやすくなります。
そして、MoEモデルに特有なのがexpertの分割です。expertは、モデル内部のフィードフォワード処理を担当する複数の専門ネットワークで、routerが入力に応じて一部を選びます。expertをGPUごとに配置するExpert Parallelismでは、選ばれたexpertを持つGPUへ処理を送り、結果を戻します。Denseモデルを2枚で動かすことと、expert単位で分けることは同じではありません。[4][5]
| 手法 | 主に何を分けるか | 通信・処理上の特徴 |
|---|---|---|
| 層の分割 | モデルの層 | 層の境界で中間結果を受け渡す。単一リクエストは担当層を順に通る |
| Tensor Parallelism | 層内の重み・演算 | 並列計算する一方、分割に応じて結果交換・集約が発生する |
| Expert Parallelism | MoEのexpert | 選ばれたexpertの配置先へ入力を送り、結果を集める |
| CPU offload | 重みや処理をCPU側へ配置 | VRAMに収まらないモデルを扱えるが、CPU・RAM・転送性能も関係する |
| Strataで注目する分担 | GPU上のexpert cacheと、CPU・RAM側のexpert計算 | 使用傾向に合わせた配置とCPU/GPU協調。複数GPUでの層分割とも組み合わさる |
これらは相互に排他的な分類ではありません。たとえば、層を2枚へ分割しながら、それぞれの担当層でGPU cacheとCPU計算を使い分ける構成もあります。Strataの特徴を「expertを2枚に割る新技術」だけで説明すると、CPUやRAMの役割を見落としてしまいます。
また、現在のllama.cppにも、層分割・重み分割・CPU側へのMoE配置に加え、CPU側expertのGPU cacheに関する設定があります。「従来は固定分割のみ、Strataだけがcacheを使う」という区分も正確ではありません。 本稿の比較は仕組みの整理で、同一モデル・同一条件で両エンジンを競わせた性能比較ではありません。[4]
Strataの公式説明では、頻繁に使うexpertをGPUのVRAMへキャッシュし、そこに保持していないexpertはRAM上の重みを使ってCPUで計算します。CPU側の結果とGPU側の結果を合わせて、次の処理へ進みます。GPUのメモリーは、expertのほか、attentionの処理や文脈を保持するKVキャッシュにも使います。[1]
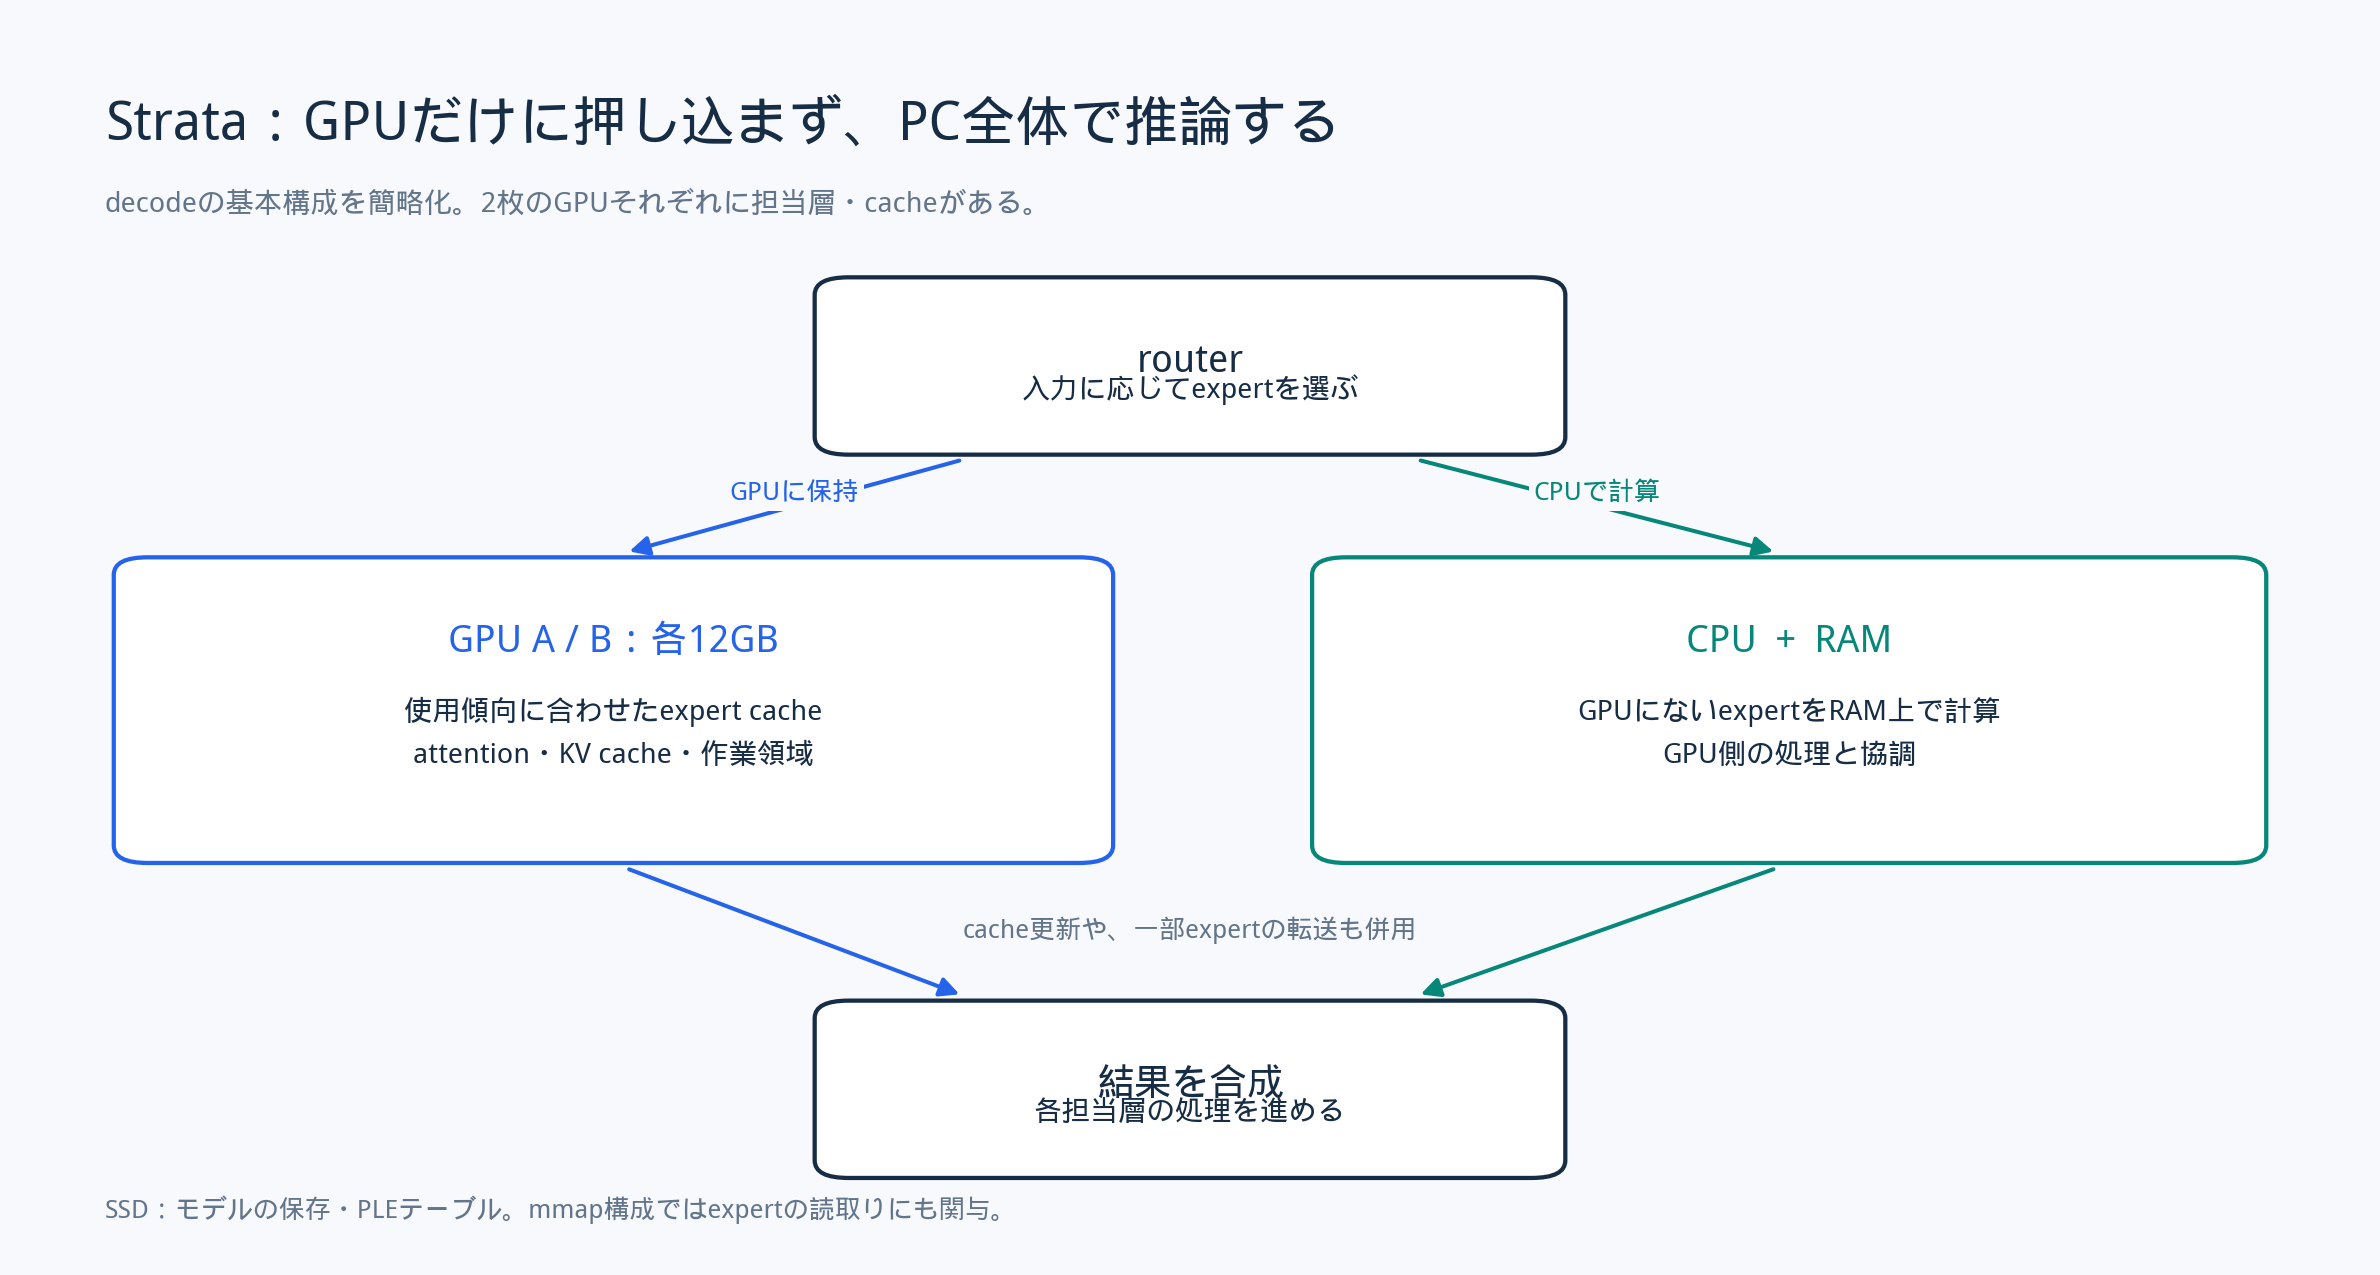
ここで大事なのは、「GPUにないから、その都度すべてGPUへ運ぶ」とは限らないことです。CPUがRAM上で計算するなら、巨大なexpert重みを毎回PCIeへ流す代わりに、CPU計算とメモリー帯域を使えます。GPUに保持できるexpertが増えれば、CPU側で計算する仕事を減らせる可能性があります。
ここまでの図は、回答を順に生成する**decode(デコード)の説明です。長い入力をまとめて読むprefill(プリフィル)**では、複数トークンをまとめて処理し、次の層のexpertをGPUへ転送するなど、分担が変わります。このため、PCIeの影響を見るときも、入力を読む時間と回答を生成する速度を分けて測ります。[1][2]
SSDの役割にも注意しておきたいところです。前述のPLEという大きなlookup tableの読取りと、RAMに収まらないexpertをファイルから読むことは別の処理です。mmap構成ではOSのpage cacheや物理SSDへのアクセスも関係します。「SSDにモデルを置いている」ことと「生成のたびに同じ量をSSDから読む」ことは同じではありません。
2枚のVRAMは公称合計24GBですが、1つの連続した24GBメモリーになるわけではありません。GPU AとGPU Bは、それぞれ別の12GBを持っています。エンジンが重み・expert cache・KV cache・作業領域を適切に配置し、GPUごとの上限を超えずに使う必要があります。
したがって、2枚目の価値は「1枚目と同じ計算を追加する」だけではありません。GPU側に保持できるモデルの部分を増やし、CPU計算やデータ移動を減らせるかもしれない、という点にあります。ただし、分割・同期・追加バッファの費用も生じます。
| 期待できること | そのままでは言えないこと |
|---|---|
| 1枚より多くの重み・expertをGPU側に置ける可能性 | 24GBカード1枚と同じ使い勝手・性能になる |
| GPUが担当できるexpertを増やせる可能性 | VRAMの24GBすべてをexpert cacheに使える |
| 手元のGPUを追加して構成を拡張できる | GPUを2枚にすれば速度が2倍になる |
| CPU・RAMと組み合わせ、VRAM総量を超えるモデルを扱う | 125Bモデル全体が24GB VRAM内に収まっている |
今回使ったIQ3_SのGGUF本体は2 shardで約77.88GiBあります。ファイル容量がそのまま実行時RAM使用量になるわけではありませんが、少なくとも「24GBへモデル全体を格納して動かした」という試験ではありません。[9]
RTX 3060はNVLinkにも対応していません。PCIe peer-to-peerの利用可否や実際の転送経路は、ドライバー・機器構成・対応照会で確認する必要があり、図ではGPU同士が高速直結されているようには描いていません。[6][8]
| 項目 | 構成 |
|---|---|
| CPU | Intel Core i5-13500:6 Pコア+8 Eコア、20スレッド |
| RAM | DDR4 64GB |
| GPU | GeForce RTX 3060 12GB×2 |
| マザーボード | MSI PRO Z790-P DDR4 |
| ストレージ | NVMe SSD 500GB |
| OS | Ubuntu 22.04.5 LTS |
| モデル | Qwen3.8-Flash-Next、IQ3_S |
| 新旧比較 | 旧engine 0.1.40/新engine 0.1.46 |
| 実作業クライアント | 別PC上のOpenCode v2.0.24 |
推論サーバーとOpenCodeの実行PCは分けました。GPU推論とエージェントの実行環境を、必ず同じPCに置く必要はありません。
このボードの公式仕様では、上段の長いスロットはCPU直結のPCIe 5.0 x16、下段はチップセット接続のPCIe 4.0 x4です。RTX 3060はGen4対応なので、上段でもカード側の上限はGen4 x16になります。この構成はx8+x8ではなく、x16+x4で、接続元も違います。[6][7]
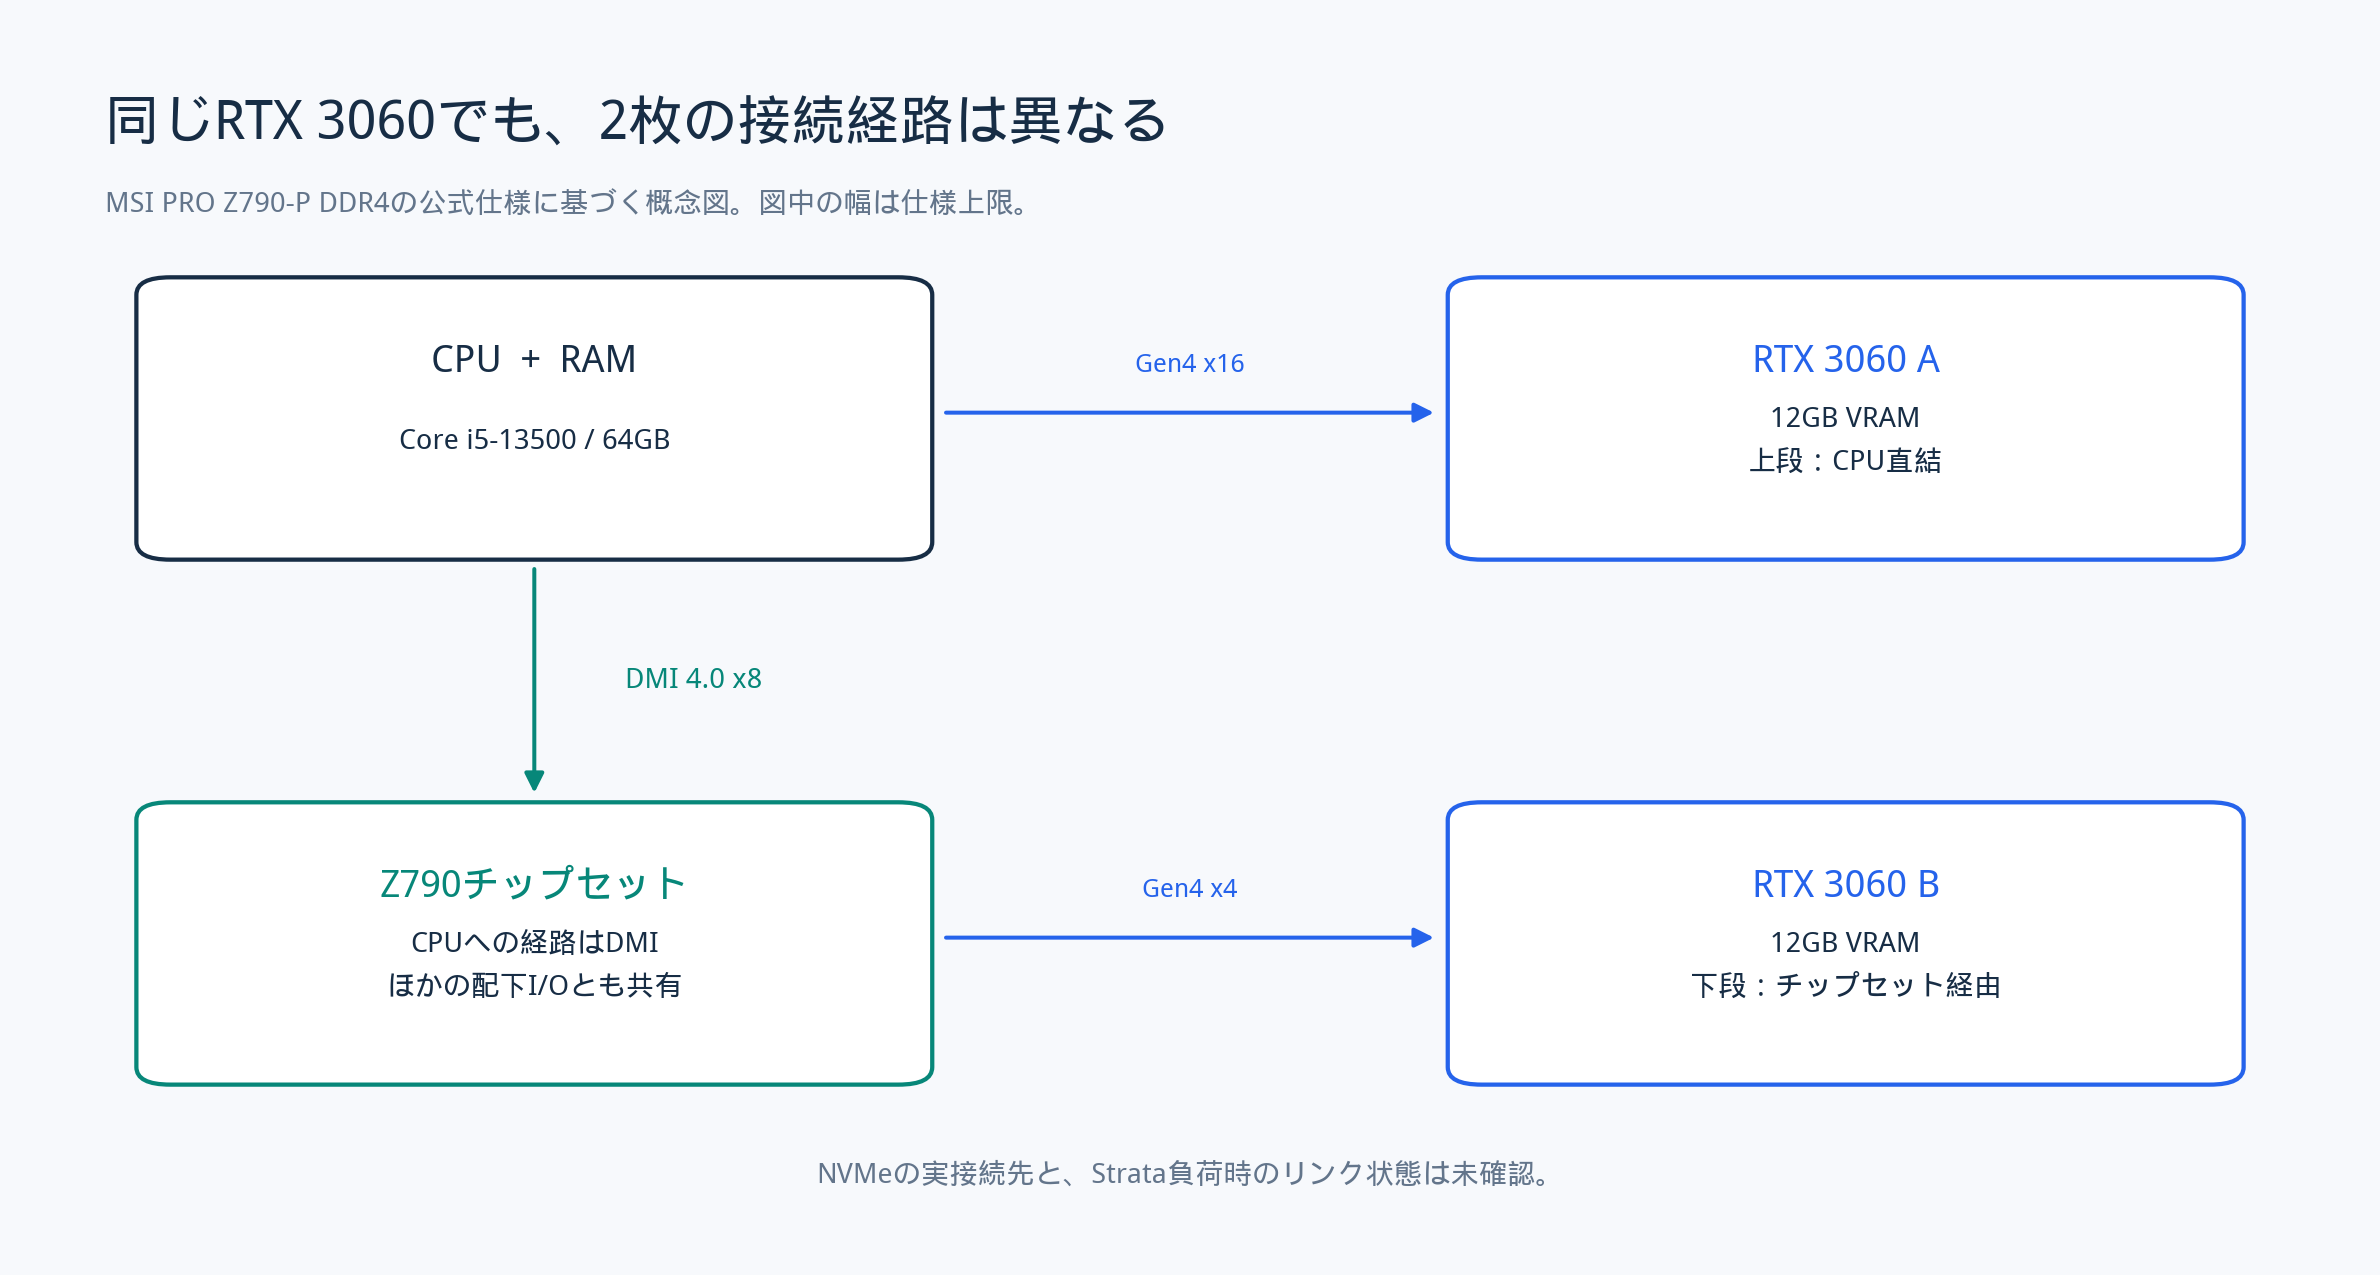
図2:ボード公式仕様に基づく経路です。図中の幅はスロット/カード仕様上の上限であり、Strata負荷時の実測リンク状態ではありません。NVMeの実接続先は未確認のため、CPU側かチップセット側かを確定して描いていません。
CPUの仕様がx8+x8分割に対応していても、マザーボードが配線していなければ使えません。BIOSだけで下段スロットへCPUレーンを追加できるわけではありません。
PCIe 4.0は1レーンあたり16GT/sです。128b/130b符号化を考慮した片方向の理論帯域は、x16で約31.51GB/s、x8で約15.75GB/s、x4で約7.88GB/sになります。
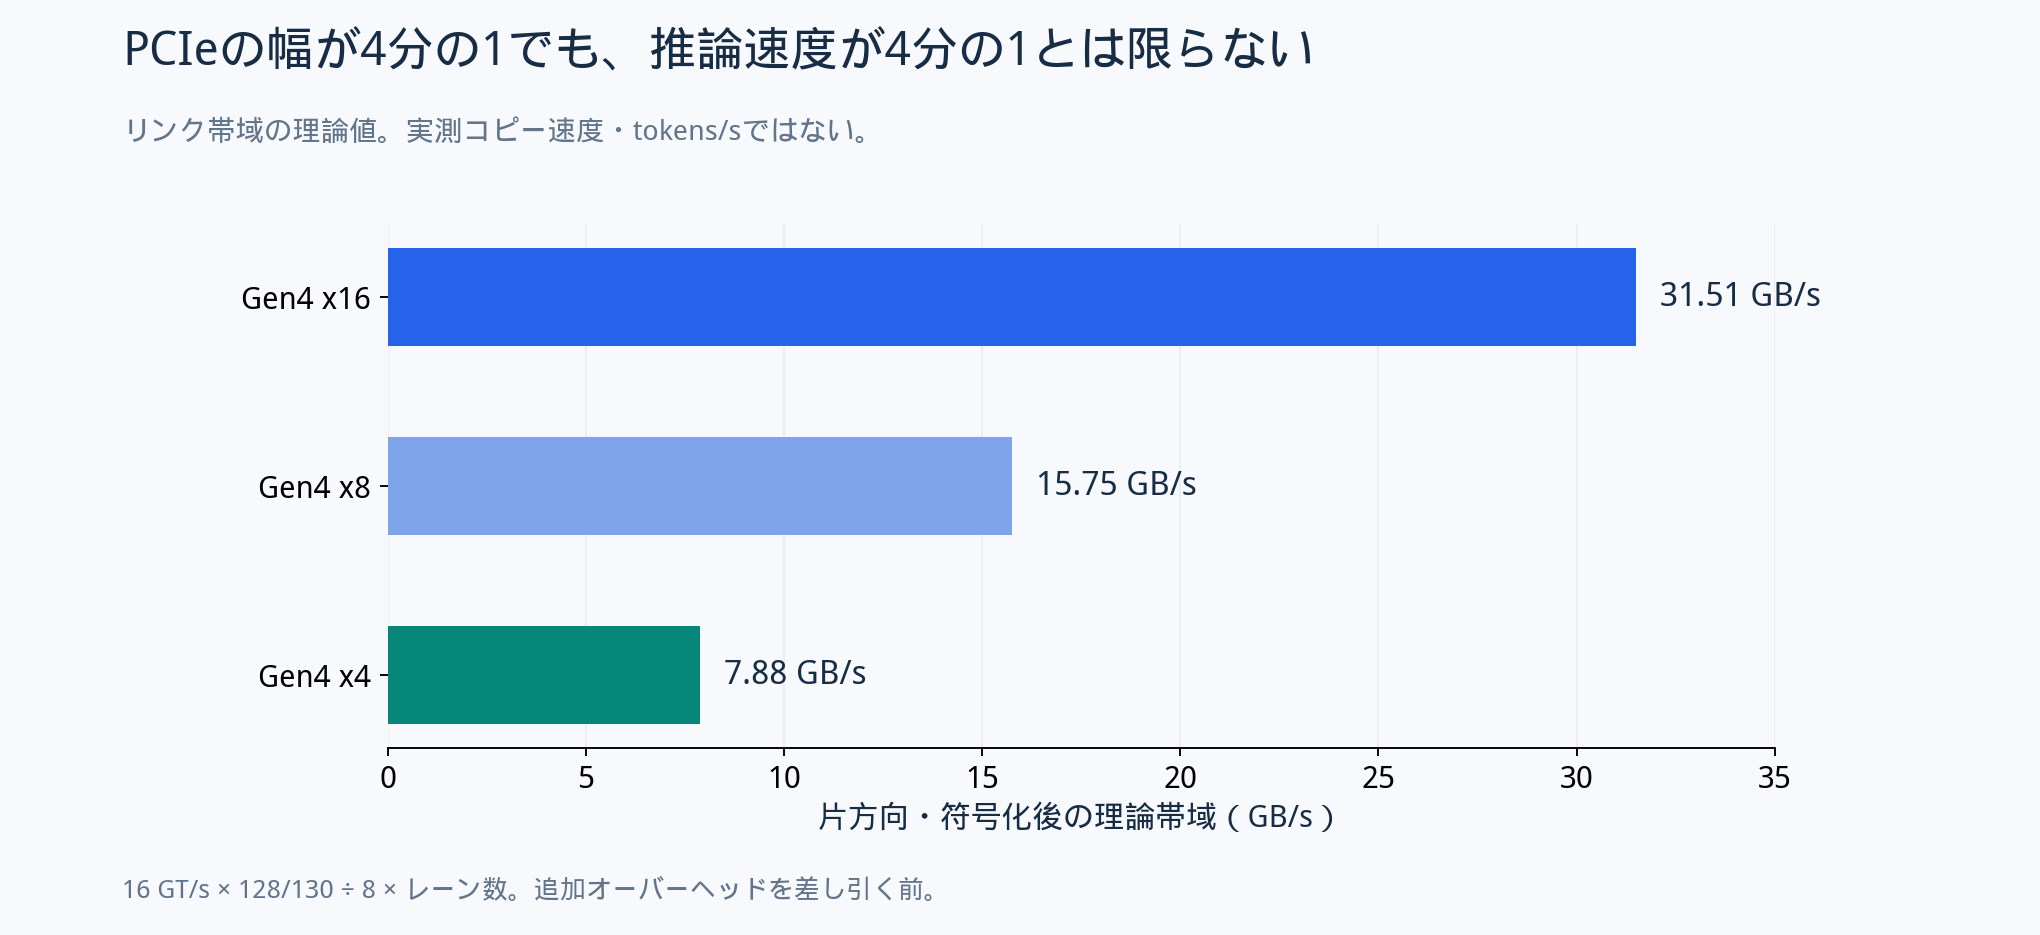
この数字だけを見ると、下段のGPUはかなり不利に見えます。ただ、推論時間にはGPU演算、CPUのexpert計算、RAMアクセス、転送、同期が含まれます。PCIeが遅くなったときの影響は、このうち転送待ちがどれだけを占めるかで変わります。転送と演算を重ねられれば、一部の転送時間は待ち時間として表面に出ません。[8]
下段GPUの通信は、チップセットからDMIを経てCPU側へ向かいます。DMI 4.0 x8はほかのチップセット配下I/Oとも共有されますが、それだけで競合や飽和を断定はできません。NVMeの接続先、page cacheの状態、実際の転送方向と量も確認が必要です。[7]
また、層を順に処理する構成では、GPU AとBが常に同時に同じ量の演算をするとは限りません。「GPU使用率が高い」「下段がx4」という単独の情報だけで、ボトルネックを特定することはできません。
CPU側も、比較するときは条件を固定しておきたいところです。今回の旧合格構成はexpert workerを5本とし、別々のPコアへ割り当てました。コア数を増やせば必ず速くなるわけではなく、RAM帯域や同期の競合も関係します。GPU構成を比較するなら、CPU設定もそろえる必要があります。[9]
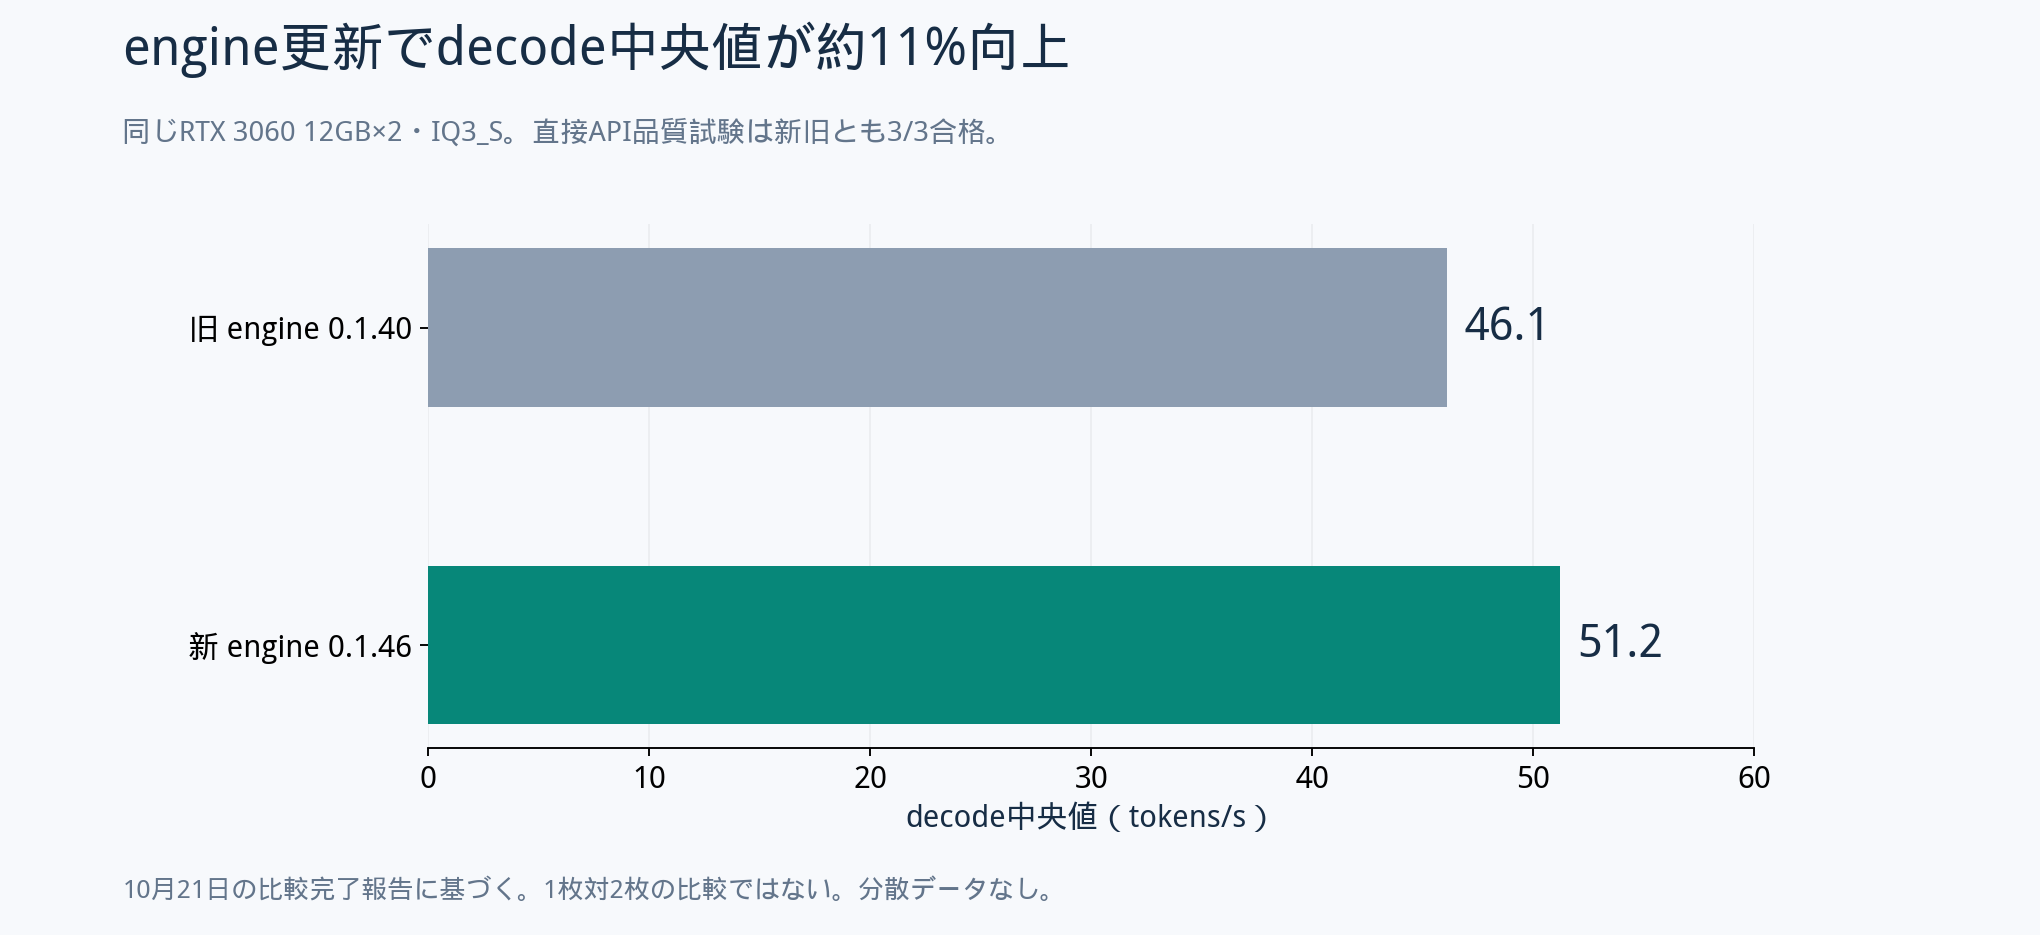
10月21日の比較では、既存IQ3_Sとpackを使い、新版engine 0.1.46を別環境に導入しました。MTP資産を読み込まない旧合格条件を基準に、新旧の直接API品質試験と、同じOpenCode v2.0.24からの課題を比較しました。[9]
本稿のMTP OFFは、MTP資産を読み込まない条件です。prompt lookupなど、すべての投機的処理を無効にしたという意味ではありません。[2][9]
| 項目 | 旧engine 0.1.40 | 新engine 0.1.46 |
|---|---|---|
| 直接API品質試験 | 3/3合格 | 3/3合格 |
| decode中央値 | 46.1 tok/s | 51.2 tok/s |
| prefill・総時間 | 比較基準 | ほぼ同等 |
| OpenCode v2の課題 | 10/10合格 | 10/10合格 |
| tool失敗件数 | 5件 | 0件 |
| 最大実入力tokens | 230,867 | 230,526 |
| OpenCode自動圧縮 | あり | あり |
結果は、decode中央値が46.1から51.2 tok/sへ、約11%の改善でした。同じGPUとモデルでも、engineの更新で生成速度が上がったことになります。一方、prefillと総時間はほぼ同等でした。
エージェントは、回答を生成するたびに、それまでの会話やツールの結果を読みます。過去のDGX Sparkの記事でも、入力の再処理を減らすプレフィックスキャッシュが、多ターンの待ち時間に効くことを確認しました。[11] 今回も生成速度に加え、入力処理と課題完了までの時間を見る必要があります。
OpenCodeでは新旧とも全課題に合格し、この試験でのtool失敗は5件から0件になりました。ただし、試行数と課題範囲は限られており、一般的な失敗率を推定できる結果ではありません。reserve誤設定の予備3件は記録を保持し、主比較から外しています。
今回の検証で確認できたのは、中古のRTX 3060 12GBを2枚と64GBのRAMを備えたPCで、Flash-Nextを実用的な生成速度で動かし、OpenCode v2の課題も完了できたことです。
直接APIで測った生成速度は、新engineで中央値51.2 tok/sでした。OpenCode v2から実行した課題は新旧とも10件すべてに合格し、新engineではtool失敗も0件でした。これまで大容量メモリー機で使ってきたモデルが、一般的なデスクトップPCの構成でも、ツールを使う実作業に応えています。[9]
長文も扱えました。直接APIでは256Kの品質試験に合格し、OpenCode v2では最大約23万tokensの入力を処理しています。OpenCode側では途中に会話の自動圧縮が入っているため、256Kの全文を保持したまま作業を続けた結果ではありませんが、長い文脈を使って課題を完了できたことは、実用上の成果です。
ここにStrataの面白さがあります。GPUのVRAMを、よく使うexpertの置き場として活用し、CPU・RAM・SSDにも仕事を分担させる。その工夫によって、176B相当の大きなモデルが、手元のPCで使えるエージェントの選択肢になったわけです。私が今回の検証でいちばん伝えたかったのは、この点です。
記事を書いている間にも更新が続いています。2026年10月24日に公式リリースとAPIを再確認した時点の最新は0.2.3.1で、10月23日22:45(日本時間)に公開されました。推論を担うengineは0.1.48です。本稿で実測した0.1.46から、さらに2世代進んでいます。[10]
| リリース | 公開日(日本時間) | 主な更新 |
|---|---|---|
| 0.2.2/engine 0.1.47 | 10月21日 | NVIDIAでのGyro高速化、GPUごとのMain/Helper/Off指定、モデル保存先の管理改善 |
| 0.2.3/engine 0.1.48 | 10月23日 | 会話キャッシュの自動容量調整、DFlash2の選択肢、Strix Haloの高速化、Intel Arc向けLinux engineの配布、チャットとTerminalの安定性改善 |
| 0.2.3.1/Control 0.1.48.1 | 10月23日 | NVIDIAパッケージのセットアップ停止などを修正。アプリは0.2.3、engineは0.1.48を継続 |
今回のPCに近い話では、0.2.2でRTX 3060 12GBのGyro-Sが54.3→62.5 tok/s、Gyro-Mが50.2→54.8 tok/sになったという公式測定が出ています。それぞれ約15%、約9%の改善です。これはGyroという別の量子化形式での結果ですが、RTX 3060のような既存GPUでも、ソフトウェアの改良でまだ性能が伸びていることが分かります。[10]
エージェント用途で気になるのは、0.2.3の会話キャッシュです。空きメモリーに応じて容量を自動調整するようになり、公式の「2つのエージェントが1つのモデルを共有する」試験では、入力の再利用率が0%から91%に上がり、後続ターンの所要時間が11秒から3秒へ短縮したと報告されています。長い会話を繰り返す使い方では、こうした入力処理の改善が待ち時間に効いてきます。[10]
また、Strata自身のチャットには、文脈がいっぱいになったときの要約や復帰処理が入りました。こちらはStrataアプリ側の改善です。外部クライアントであるOpenCode v2の会話管理とは区別しますが、開発が日常的に使い続けるための部分まで進んでいるのが分かります。
DFlash2も、Terminalから明示指定して試せるようになっています。小さなモデルで先読みし、本体で確かめる投機デコードの選択肢です。現時点のAutoはMTPを使い、DFlash2は任意選択です。Strix HaloのWindows環境での高速化やIntel Arc向けLinuxパッケージも加わり、利用できるハードウェアの幅も広がっています。[10]
以上は公式発表の内容で、今回のIQ3_S・RTX 3060×2構成での追加測定はこれからです。ただ、私が今後も追いかけたい方向ははっきりしています。手元のPCでFlash-Nextを動かし、OpenCode v2に実際の仕事を任せたとき、どれだけ快適に使い続けられるか。 今回は、その出発点として十分に手応えのある結果になりました。
筆者は NPO法人 IoTメディアラボラトリーで、IoT 研究とあわせて AI 分野の検証を担当しています。東京大学・本郷キャンパス 大学院工学系研究科の同名のラボで行っていた IoT 研究が独立し、研究機関として活動を続けている組織です。 私がやっていることは、本記事のようなローカル LLM の実機検証が中心です。新しいモデルが出るたびに手元のハードで動かし、速度・日本語知識・コーディング・マルチモーダルの 4 軸で測り、動かなければ原因を突き止めるところまでやります。ベンダーの公称値ではなく、実際に自分の機械で何が起きるかを知りたいからです。 そのぶん、計算資源はいくらあっても足りません。もっと GPU が欲しい(笑)。機材の提供、検証のご依頼、共同研究など、お声がけいただけると喜びます。
[1] Strata v0.2.1:HOW_IT_WORKS — GPU cache、CPU/RAM、prefillの基本説明。
[2] Strata v0.2.1:DETAILS — expert配置、mmap、MTPを読み込まない実行、数値再現性など。
[3] 初回公式リリースv0.1.0/公式API — 公開日時。
[4] llama.cpp server公式README — 2026-10-24参照。split-mode、CPU MoE、MoE cacheの設定。現行機能の記述であり、Strata初版公開当時の機能一覧ではない。
[5] NVIDIA Megatron Core:MoE token dispatcher — MoEのexpert並列と通信の考え方。今回のPCでMegatronを実行したものではない。
[6] NVIDIA RTX 3060仕様/MSI RTX 3060製品仕様例 — PCIeとNVLink。搭載カードのメーカー型番をこの製品例で確定するものではない。
[7] MSI PRO Z790-P DDR4公式仕様/Intel Core i5-13500仕様 — スロット、CPU、DMI。
[8] CUDA Best Practices Guide/CUDA Multi-GPU Systems — 転送と演算の重畳、peer accessの条件。
[9] 筆者の10月5~9日の作業記録、10月21日の容量・準備調査、および新旧比較完了報告。今回の図表は完了報告の中央値・件数を使用し、生ログからの再集計はしていない。
[10] Strata 0.2.2/0.2.3/0.2.3.1 — 2026-10-24に最新リリースAPIとmainのコミット履歴も確認。mainの先頭は0.2.3.1の7ddc17a。Gyroの速度と会話キャッシュの短縮例は公式測定で、本稿のIQ3_S実測とは別の条件。
[11] 筆者のQiita記事:次世代Qwen4アーキテクチャ先行公開版 Qwen3.8-Flash-Next を DGX Spark で動かすコツ — 176B相当の内訳、本体量子化、PLEのSSD配置、128GB機での実績。
[12] 筆者のQiita記事:EVO-X2(Ryzen AI Max+ 395)+ Vulkan で Qwen3.8-Flash-Next が動いた! でもコンテクスト長を大きくすると不安定!残念! — GPU割当96GB、本体とPLEの配置、生成速度、長文時の制約。
[13] Qwen3.8-Flash-Next公式モデルカード — 本体125B/稼働6B、追加PLE 51BとMTP 4B、ハイブリッドattention。約352GBは176B×2 bytesによる筆者の単純計算。
[14] 筆者のQiita記事:ハーネス(OpenCode)+ローカルLLM 7モデル比較で Qwen3.8-Flash-Next が満点! — 実環境の調査・設計3課題、45点満点の結果と具体例。OpenCode 1.18.25・NVFP4による過去の検証で、本稿のv2・IQ3_S試験とは条件が異なる。