在Flask的很多扩展里面都可以先初始化扩展的对象, 然后再去调用 init_app 方法初始化
db = SQLAlcheny()
db.init_app(app)
werkzeug工具集
Flask是一个使用Python编写的轻量级Web应用框架
Flask被称为“microframework”,因为它使用简单的核心,用extension增加其他功能。
web框架的优势:
功能的封装, 重复使用, 直接用就完事了
web框架提供的功能
- 模板渲染
- 数据查询(对应的查询函数)
服务端的组成: 服务器 + WSGI + Web应用程序
Apache服务器(只能完成静态服务器请求) 后缀访问
web.py作用(接收到的请求 -- 返还给客户端) 已被封装好的,不需要管
主要的业务逻辑: web应用程序 -- 处理业务逻辑 -- 实现业务功能
以后工作的重点: 每个路由封装一个函数
application.py
web服务器: 数据入口
协助开发者快速开发web应用程序的一套功能代码(封装)
按照约定要求,装饰指定代码,专注业务逻辑
避免重复造轮子
本身相当于一个内核, 其他几乎所有的功能都要用到扩展,都需要第三方的扩展来实现.
是一个 WSGI(在 Web 应用和多种服务器之间的标准 Python 接口) 工具集。Jinja2 负责渲染模板。
实现路由、调试和Web服务器网关接口
WSGI工具箱采用werkzeug(路由模块)
Werkzeug是一个遵循WSGI协议的python函数库
- 其内部实现了很多Web框架底层的东西,比如request和response对象;
- 与WSGI规范的兼容;支持Unicode;
- 支持基本的会话管理和签名Cookie;
- 集成URL请求路由等。
Werkzeug库的 routing 模块负责实现 URL 解析。不同的 URL 对应不同的视图函数,routing模块会对请求信息的URL进行解析,匹配到URL对应的视图函数,执行该函数以此生成一个响应信息。
routing模块内部有:
- Rule类
- 用来构造不同的URL模式的对象,路由URL规则
- Map类
- 存储所有的URL规则和一些配置参数
- BaseConverter的子类
- 负责定义匹配规则
- MapAdapter类
- 负责协调Rule做具体的匹配的工作
模板渲染引擎, 也是Flask框架的核心
所有 Flask 应用都必须创建一个应用实例。Web 服务器使用一种名为 Web 服务器网关接口(WSGI,Web server gateway interface,读作“wiz-ghee”)的协议,把接收自客户端的所有请求都转交给这个对象处理。应用实例是 Flask 类的对象,通常由下述代码创建:
from flask import Flask
app = Flask(__name__)
Flask 类的构造函数只有一个必须指定的参数,即应用主模块或包的名称。在大多数应用中,Python 的 name 变量就是所需的值。
**提示:**传给 Flask 应用构造函数的 name 参数可能会让 Flask 开发新手心生困惑。Flask 用这个参数确定应用的位置,进而找到应用中其他文件的位置,例如图像和模板。 后文会介绍更复杂的应用初始化方式,不过对简单的应用来说,上面的代码足够了。
客户端(例如 Web 浏览器)把请求发送给 Web 服务器,Web 服务器再把请求发送给 Flask 应用实例。
应用实例需要知道对每个 URL 的请求要运行哪些代码,所以保存了一个 URL 到 Python 函数的映射关系。
路由: 处理URL和函数之间关系的程序
app.route()装饰器把一个函数绑定到对应的URL上
from flask import Flask
app = Flask(__name__)

@app.route('/')
def index():
    return 'Index Page'

@app.route('/hello')
def hello():
    return 'Hello World'

if __name__ ='__main__':
    app.run(debug=True)
这样你可以构造含有动态部分的 URL,也可以在一个函数上附着多个规则。
静态文件访问 / 模板渲染
视图函数(views)
视图函数: 装饰器路由下被修饰的程序(注册程序), 用来处理入站请求的函数
每当访问绑定的固定域名后会触发服务器执行index()函数.
这个函数的返回值称为 响应. 是客户端接收到的内容. 如果客户端是web浏览器, 响应就是显示给用户查看的文档. 视图函数返回的响应可以是包含HTML的简单字符串, 也可以是后文将介绍的复杂表单
URL地址中可能会包含可变部分 https://github.com/<your-name>, 用户名(your-name)是地址的一部分.
@app.route('/user/<name>')
def user(name):
	return '<h1> Hello, {}!
打印路由列表
app.url_map 属性可以实现路由列表打印
动态路由
仅用于开发和测试, 不用于部署生产服务器
# 启动方法一 bash窗口下
export FLASK_APP=main.py
flask run
# 启动方法二 主脚本尾部添加下述代码
if __name__ == '__main__':
app.run(debug=True)
# 该方法还被用于单元测试你可以构造含有动态部分的 URL,也可以在一个函数上附着多个规则。
# 创建动态路由
@app.route('/user/<name>')
def user(name):
    return '<h1>Hello, {}!</h1>'.format(name)
@app.route('/post/<int:post_id>')
def show_post(post_id):
    # show the post with the given id, the id is an integer
    return 'Post %d' % post_id
变量规则
要给 URL 添加变量部分,你可以把这些特殊的字段标记为 <variable_name> , 这个部分将会作为命名参数传递到你的函数。路由传递的参数默认当做string处理, 也可以指定参数的类型。规则可以用<converter:variable_name>指定一个可选的转换器。常见的转换器有 int, float, path 等, 还可以自定义转换器
当用户发起访问请求书 服务器会截取<name> 的参数传递到视图函数
默认在浏览器地址栏回车访问的方式都是'GET'
@app.route('/demo',methods=['GET', 'POST'])
def demo():
    # 业务逻辑代码
return request.method # 表现逻辑调试模式默认禁用
调试模式下, 开发服务器默认会加载两个便利的工具: 重载器 和 调试器
重载器的作用: 监听项目中的所有源码文件, 发现变动时自动重启服务器. 每次修改并保存源码文件后, 服务器都会自动重启, 让改动生效
调试器的作用:基于web的工具, 当应用抛出未处理的异常时, 它会出现在浏览器中.
# bash窗口模式下启动调试模式
export FLASK_APP=main.py
export FLASK_DEBUG=1
flask run

# 官方文档使用这种方式
export FLASK_ENV = development
# ====从对象中加载配置===== #
class Config:
DEBUG = True
app.config.from_object(Config)
# =====从文件中加载配置==== #
app.config.from_pyfile('config.ini')
# 确保被程序只有在被作为脚本时才能执行, 作为模块导入时不会被执行
# ====从环境变量中加载配置==== #
app.config.from_envvar('ENVCONFIG')
# 在环境变量中添加参数 ENVCONFIG :/home/wwfyde/Documents/myflask/config.ini
# [推荐]一些常用的配置 可以通过app.常用配置
app.debug = True
# 运行函数中传入debug参数
app.run(debug=True)千万不要在生产服务器中启动调试模式
客户端通过调试器能请求执行远程代码, 因此可能导致生产服务器遭到攻击.
这个工具 对于开发web程序,还是做爬虫都及其有用
功能: 一款功能强大的网页调试与发送网页HTTP请求的工具
作用: 可以直接去对我们写出来的路由和视图函数进行调试, 作为后端程序员是必须要知道的一个工具
flask --help
flask  # 等同于 flask --help
# flask run作用是在web开发服务器中运行应用
flask run --help
# 告诉web服务器在哪个网络接口上监听客户端发来的连接
--host
# 监听同一网络中的接收到其他连接
flask run --host 0.0.0.0
需求: 在代码中定义一个字典, 并将字典转化为JSON数据格式的字符串
使用Flask写一个接口时候需要给客户端返回JSON数据, 在Flask中可以直接jsonify 生成一个JSON的响应
客户端期待的响应格式基本都是json格式, 也就是说一个response对象其实就是一个 json格式的文本对象
@app.route('/demo4')
def demo4():
    json_dict = {
        "user_id":10,
        "user_name":"laowang"
    }
    # 用法说明:可以传入的参数, *args 和**kwargs
    return jsonify(json_dict,name='jkq',age=18)
以下方法不推荐:
@app.route('/demo')
def index():
    json_dict = {
        'name': 'laowang',
        'age':18
    }
    # json.dump将字典转换成json格式的字符串
    result = json.dumps(json_dict)
    new = json.loads(result)
    print(type(new))
return resultredirect: 将当前视图函数重定向到另外一个路由
url_for: 指向已定义的视图函数并传入参数
@app.route('/redirect')
def demo5():
    # url_for: 取到指定视图函数,并转到该url, 并且可以携带参数(视图函数的参数)
    # 重定向到自己写的视图函数
    # return redirect('https://www.baidu.com')

    # url_for:取到指定视图函数所对应的路由URL,并且可以携带参数
    # 注意传入参数的方式 endpoint='demo3'
    return  redirect(url_for('demo3'))

# 实现带参数的路由
@app.route('/user/<user_name>')
def user(user_name):
    return 'hello,{}'.format(user_name)

@app.route('/redirect')
def demo5():
    # user是视图函数名, user_name 是user视图函数的参数
return redirect(url_for('user', user_name=100))在 Flask 中,可以很方便的返回自定义状态码,以实现不符合 http 协议的状态码,例如:status code: 666
@app.route('/demo6')
def demo6():
return '状态码为 666',666在 web 开发中,可能会出现限制用户访问规则的场景,那么这个时候就需要用到正则匹配,根据自己的规则去限定请求参数再进行访问
具体实现步骤为:
- 导入转换器基类:在 Flask 中,所有的路由的匹配规则都是使用转换器对象进行记录
- 自定义转换器:自定义类继承于转换器基类
- 添加转换器到默认的转换器字典中
- 使用自定义转换器实现自定义匹配规则
abort(400)
捕获异常
- errorhandler装饰器
- 注册一个错误处理程序, 当程序抛出制定错误的状态码的时候, 就会调用该装饰器所装饰的方法
- 参数
- code_or_exception - HTP的 错误状态码或指定异常
- 例如统一处理状态码为500的错误给用户友好的提示
@app.errorhandler(500)
def zero_division_error(e):
return '除数不能为零'Flask的工作方式: 特定条件触发某项任务
作用: 为了避免在每个视图函数中都重复编写代码, Flask提供了祖册通用函数的功能, 注册的函数可在请求被分派到视图函数之前或之后调用.
请求钩子可以理解为通用函数代码, 请求钩子是通过装饰器的形式实现
from flask import Flask
from flask import abort

app = Flask(__name__)


# 在第一次请求之前调用,可以在此方法内部做一些初始化操作
@app.before_first_request
def before_first_request():
    print("before_first_request")


# 在每一次请求之前调用,这时候已经有请求了,可能在这个方法里面做请求的校验
# 如果请求的校验不成功,可以直接在此方法中进行响应,直接return之后那么就不会执行视图函数
@app.before_request
def before_request():
    print("before_request")
    # if 请求不符合条件:
    #     return "laowang"


# 在执行完视图函数之后会调用,并且会把视图函数所生成的响应传入,可以在此方法中对响应做最后一步统一的处理
@app.after_request
def after_request(response):
    print("after_request")
    response.headers["Content-Type"] = "application/json"
    return response


# 请每一次请求之后都会调用,会接受一个参数,参数是服务器出现的错误信息
@app.teardown_request
def teardown_request(e):
    print("teardown_request")


@app.route('/')
def index():
    return 'index'

if __name__ == '__main__':
app.run(debug=True)为了避免大量可有可无的参数把视图函数弄得一团糟,Flask 使用上下文临时把某些对象变为全局可访问。
context: 上下文, 情景, 环境, 文本对象, 相当于一个容器
上下文: 相当于一个容器, 保存了Flask程序运行过程中的一些信息
Flask使用上下文让特定的变量在一个线程中全局可访问, 与此同时却不会干扰其他线程.
Flask 每响应一个http请求, 就会创建一个 request 对象, 这个request对象对应的上下文, 就是request context
思考:在视图函数中,如何取到当前请求的相关数据?比如:请求地址,请求方式,cookie等等
在 flask 中,可以直接在视图函数中使用 request 这个对象进行获取相关数据,而 request 就是请求上下文的对象,保存了当前本次请求的相关数据,请求上下文对象有:request、session
- request
- 封装了HTTP请求的内容,针对的是http请求。举例:user = request.args.get('user'),获取的是get请求的参数。
- session
- 用来记录请求会话中的信息,针对的是用户信息。举例:session['name'] = user.id,可以记录用户信息。还可以通过session.get('name')获取用户信息。
它的字面意思是 应用上下文,但它不是一直存在的,它只是request context 中的一个对 app 的代理(人),所谓local proxy。它的作用主要是帮助 request 获取当前的应用,它是伴 request 而生,随 request 而灭的。
应用上下文对象有:current_app,g
current_app 当前应用的应用实例(实例化了才会产生的对象)
g 处理请求时用作临时存储的对象, 每次请求都会重设这个变量
应用程序上下文,用于存储应用程序中的变量,可以通过current_app.name打印当前app的名称,也可以在current_app中存储一些变量,例如:
- 应用的启动脚本是哪个文件,启动时指定了哪些参数
- 加载了哪些配置文件,导入了哪些配置
- 连了哪个数据库
- 有哪些public的工具类、常量
- 应用跑再哪个机器上,IP多少,内存多大
current_app.name
current_app.test_value='value'
说明: 获取应用上下文的方法是在应用实例上调用app.app_context()3
# 当前项目中
from session import app
from flask import current_app
current_app.name
# 这个时候会报错, 因为并未产生current_app上下文, 只有当推送玩上下文之后才可以被调用
app_ctx = app.app_context()
app_ctx.push()
current_app.name
app_ctx.pop()g 作为 flask 程序全局的一个临时变量,充当者中间媒介的作用,我们可以通过它传递一些数据,g 保存的是当前请求的全局变量,不同的请求会有不同的全局变量,通过不同的thread id区别
g.name='abc'注意:不同的请求,会有不同的全局变量
- 请求上下文:保存了客户端和服务器交互的数据
- 应用上下文:flask 应用程序运行过程中,保存的一些配置信息,比如程序名、数据库连接、应用信息等
上下文中的对象只能在指定上下文中使用,超出范围不能使用 请求上下文和应用上下文原理实现:https://segmentfault.com/a/1190000004223296
request就是flask中代表当前请求的 request 对象,其中一个请求上下文变量(理解成全局变量,在视图函数中直接使用可以取到当前本次请求)
常用属性
| 属性 | 说明 | 类型 |
|---|---|---|
| data | 记录请求的数据,并转换为字符串 | * |
| form | 记录请求中的表单数据 | MultiDict |
| args | 记录请求中的查询参数 | MultiDict |
| cookies | 记录请求中的cookie信息 | Dict |
| headers | 记录请求中的报文头 | EnvironHeaders |
| method | 记录请求使用的HTTP方法 | GET/POST |
| url | 记录请求的URL地址 | string |
| files | 记录请求上传的文件 | * |
@app.route('/',methods=['POST'])
def index():
    pic = request.files.get('pic')
    pic.save('images/test.jpg')
    return '测试'
需要配合postman实现, 因为需要用到 post请求
实现状态保持的方式是使用cookie 和session
HTTP是一种无状态协议,浏览器请求服务器是无状态的.
每次请求都是独立的, 它的执行情况和结果与前面的请求和之后的请求是无直接关系的. 两次请求彼此独立/
无状态: 用户的每次请求是一次新的请求, 请求的数据是一次性的
无状态原因: 浏览器与服务器是使用socket套接字进行通信的, 服务器将请求结果返回给浏览器之后, 会关闭当前的socket连接, 而且服务器也会在处理页面完毕之后销毁页面对象.
状态保持需求场景
-
登录状态
-
浏览记录
实现 状态请求的两种方式:
- 在客户端存储信息使用
Cookie - 在服务端存储信息使用
Session
Cookie:指某些网站为了辨别用户身份、进行会话跟踪而储存在用户本地的数据(通常经过加密)。
- 复数形式Cookies。
- Cookie最早是网景公司的前雇员Lou Montulli在1993年3月的发明。
- Cookie是由服务器端生成,发送给客户端浏览器,浏览器会将Cookie的key/value保存,下次请求同一网站时就发送该Cookie给服务器(前提是浏览器设置为启用cookie)。
- Cookie的key/value可以由服务器端自己定义。
应用:
- 最典型的应用是判定注册用户是否已经登录网站,用户可能会得到提示,是否在下一次进入此网站时保留用户信息以便简化登录手续,这些都是Cookie的功用。
- 网站的广告推送,经常遇到访问某个网站时,会弹出小窗口,展示我们曾经在购物网站上看过的商品信息。
- 购物车,用户可能会在一段时间内在同一家网站的不同页面中选择不同的商品,这些信息都会写入Cookie,以便在最后付款时提取信息。
提示:
- Cookie是存储在浏览器中的一段纯文本信息,建议不要存储敏感信息如密码,因为电脑上的浏览器可能被其它人使用
- Cookie基于域名安全,不同域名的Cookie是不能互相访问的
- 当浏览器请求某网站时,会将本网站下所有Cookie信息提交给服务器,所以在request中可以读取Cookie信息
from flask imoprt Flask,make_response
@app.route('/cookie')
def set_cookie():
    resp = make_response('this is to set cookie')
    resp.set_cookie('username', 'itcast')
return resp- 对于敏感、重要的信息,建议要存储在服务器端,不能存储在浏览器中,如用户名、余额、等级、验证码等信息
- 在服务器端进行状态保持的方案就是
Session - Session依赖于Cookie
- Session 一般存储在 Redis 或 MySQL 中
CSRF攻击原理
模板的作用: 返回响应内容, 实现表现逻辑
jinja2模板引擎
视图函数的作用很明确,即生成请求的响应,这是最简单的请求.
实际上,视图函数有两个作用:处理业务逻辑和返回响应内容(表现逻辑)。在大型应用中,把业务逻辑和表现内容放在一起,会增加代码的复杂度和维护成本。本节学到的模板,它的作用即是承担视图函数的另一个作用,即返回响应内容。
以用户在网站中注册新账户的过程为例。
-
用户在表单中输入电子邮件地址和密码,然后点击提交按钮。
-
服务器接收都包含用户输入数据的请求, 然后Flask把请求分派给处理注册请求的视图函数.
-
这个视图函数需要访问数据库, 添加新用户, 然后生成响应会送浏览器, 指明操作成功还是失败. 这两个过程分别称为业务逻辑和表现逻辑.
业务逻辑: 根据请求,作出响应, 返回响应内容之前执行特定任务
表现逻辑: 响应, 显示操作结果, 用于显示
- 模板其实是一个包含响应文本的文件,其中用占位符(变量)表示动态部分,告诉模板引擎其具体的值需要从使用的数据中获取
- 使用真实值替换变量,再返回最终得到的字符串,这个过程称为“渲染”
- Flask是使用 Jinja2 这个模板引擎来渲染模板
使用模板的好处:
- 视图函数只负责业务逻辑和数据处理(业务逻辑方面)
- 而模板则取到视图函数的数据结果进行展示(视图展示方面)
- 代码结构清晰,耦合度低(连接结构简单)
在实际开发中,强调前后端分离, 使用到模板的情形也不是很多
两个概念:
Jinja2:是 Python 下一个被广泛应用的模板引擎,是由Python实现的模板语言,他的设计思想来源于 Django 的模板引擎,并扩展了其语法和一系列强大的功能,其是Flask内置的模板语言。
模板语言:是一种被设计来自动生成文档的简单文本格式,在模板语言中,一般都会把一些变量传给模板,替换模板的特定位置上预先定义好的占位变量名。
设置模板语言 jinja2 设置里面
- Flask提供的render_temlate函数封装了该模板引擎
- render_template 函数的第一个参数是模板的文件名,后面的参数都是键值对,表示模板中变量对应的真实值。
在模板中使用
{{}}来表示变量名, 这种{{}}语法叫做变量代码块
<h1>{{post.title}}</h1>
Jinja2 模版中的变量代码块可以是任意 Python 类型或者对象,只要它能够被 Python 的 str() 方法转换为一个字符串就可以.
默认会对标签符号进行转义, 使其当做普通字符串处理
用{%%} 定义的 控制代码块, 可以实现一些语言层次的功能, 比如循环或者if语句
用法示例:
<ul>
    {% for index in indexs %}
    <li>{{ index }}</li>
    {% endfor %}
</ul>
使用 {# #} 进行注释, 注释的内容不会再html中被渲染出来
{#{{str | safe}} #}
在项目下创建 templates 文件夹, 用于存放所有的模板文件, 并在目录下创建一个模板html文件 temp_demo1.html
设置templates文件夹属性以便能够在代码中智能提示:
file >> setting >> Project:Template >> Project Structure >> focuse on templates >> Mark as Templates >> Apply

选中目录 >> 右键 >> Mark Directory AS >> Templates
设置html中的模板语言, 以便在HTML中有智能提示
file >> setting >> Python Template Language >> Jinja2 >> OK
创建视图函数, 将该模板内容进行渲染并返回
@app.route('/')
def index():
    return render_template('temp_demo1.html')
代码中传入字符串, 列表, 字典到模板中
@app.route('/')
def index():
    mystr = '<h1>Ting</h1>'
    mylist = ['wwfyde', 'Asa', 'wacfey']
    mydict = {'name': 'Ting', 'age': 18}
return render_template('test.html', mystr=mystr, mydict=mydict, mylist=mylist)<body>
{{ mystr }}
这是安全模式: {{ mystr | safe }}
<br>
{{ mylist }}
<br>
{{ mydict }}
</body>
变量间支持运算, 会将变量先处理, 再字符串化
规则类似JavaScript
if / else if / else / endif
for / endfor
{% if False %}
    当结果为真时输出
{% else %}
    当结果为假时输出
{% endif %}
{% for post in posts if post.text %}
    <div>
        <h1>{{ post.title }}</h1>
        <p>{{ post.text | safe }}</p>
    </div>
{% endfor %}
禁用自动转义的方法
- 在传递到模板之前,用
Markup对象封装 HTML字符串。一般推荐这个方法。 - 在模板中,使用
|safe过滤器显式地标记一个字符串为安全的 HTML ({{myvariable|safe }})。 - 临时地完全禁用自动转义系统。
{% autoescape false %}
    <p>autoescaping is disabled here
    <p>{{ will_not_be_escaped }}
{% endautoescape %}
过滤器的本质就是函数。有时候我们不仅仅只是需要输出变量的值,我们还需要修改变量的显示,甚至格式化、运算等等,而在模板中是不能直接调用 Python 中的某些方法,那么这就用到了过滤器。
使用方式:标识符 |
- 过滤器的使用方式为:变量名 | 过滤器。
- 支持链式调用
{{ 'hello world' | reverse | upper }}
查看官网
列表操作
first last length sum sort reverse
语句块过滤
{% filter upper %}
    #一大堆文字#
{% endfilter %}
过滤器的本质是函数。当模板内置的过滤器不能满足需求,可以自定义过滤器。自定义过滤器有两种实现方式:
- 一种是通过Flask应用对象的 add_template_filter 方法
- 通过装饰器来实现自定义过滤器
重要:自定义的过滤器名称如果和内置的过滤器重名,会覆盖内置的过滤器。
应用场景:
- 多个模板具有完全相同的顶部和底部内容
- 多个模板中具有相同的模板代码内容,但是内容中部分值不一样
- 多个模板中具有完全相同的 html 代码块内容
实现以上目标需要通过Jinja2模板来实现
- 把它看作 Jinja2 中的一个函数,它会返回一个模板或者 HTML 字符串
- 为了避免反复地编写同样的模板代码,出现代码冗余,可以把他们写成函数以进行重用
- 需要在多处重复使用的模板代码片段可以写入单独的文件,再包含在所有模板中,以避免重复
把宏单独抽取出来, 封装成html文件, 其他模板中导入使用, 可以使用别名
在其他模板文件中先导入再调用
{#从文件导入#}
{% import 'macro.html' as test %}
{% import 'macro.html' as cese %}

{#调用#}
{{ cese.function1() }}
{{ cese.function1() }}
{{ cese.function1() }}
{{ cese.function1() }}
应用实例
{#定义宏#}
{# input 表示函数名#}
{% macro input(label='',type='', name='')  %}
    <label>{{ label }}</label><input type="{{ type }}" name="{{ name }}"><br>
{% endmacro %}

{#调用宏#}
<form action="">
    {{ input(label='用户名', type='text', name='un') }}
    {{ input(label='用户名', type='text', name='un') }}
    {{ input(label='用户名', type='text', name='un') }}
    {{ input(label='用户名', type='text', name='un') }}
    {{ input(label='用户名', type='text', name='un') }}
</form>
模板继承是为了重用模板中的公共内容。一般Web开发中,继承主要使用在网站的顶部菜单、底部。这些内容可以定义在父模板中,子模板直接继承,而不需要重复书写。
标签定义内容
{% block top %}
{% endblock %}
- 相当于在父模板中挖个坑,当子模板继承父模板时,可以进行填充。
- 子模板使用 extends 指令声明这个模板继承自哪个模板
- 父模板中定义的块在子模板中被重新定义,在子模板中调用父模板的内容可以使用super()
父模板
{% block top %}
顶部菜单
{% endblock top %}

{% block content %}
{% endblock content %}

{% block bottom %}
  底部
{% endblock bottom %}
子模板
{% extends 'base.html' %}
{% block content %}
 需要填充的内容
{% endblock content %}
模板继承使用时注意点:
- 不支持多继承
- 为了便于阅读, 在子模板使用extends时, 尽量写在模板的第一行
- 不能再一个模板文件中定义多个相同名字的block标签
- 当在页面中使用多个block标签时, 建议给结束标签起个名字, 当多个block嵌套时, 阅读性更好
Jinja2模板中,除了宏和继承,还支持一种代码重用的功能,叫包含(Include)。它的功能是将另一个模板整个加载到当前模板中,并直接渲染。
有点类似于frame框架功能
使用方法
{% include 'hello.html' %}
包含在使用时, 如果包含的模板文件不存在时, 程序会抛出 TemplateNotFound
异常, 可以加上 ignore missing 关键字. 如果包含的模板文件不存在, 会忽略这条include语句.
{% include 'hello.html' ignore missing %}
- 宏(Macro)、继承(Block)、包含(include)均能实现代码的复用。
- 继承(Block)的本质是代码替换,一般用来实现多个页面中重复不变的区域。
- 宏(Macro)的功能类似函数,可以传入参数,需要定义、调用。
- 包含(include)是直接将目标模板文件整个渲染出来。
需求: 模板中访问一些Flask默认内置的函数和对象
从模板中直接访问Flask当前的config对象:
{{
Web 表单是 Web 应用程序的基本功能。
它是HTML页面中负责数据采集的部件。 表单有三个部分组成:表单标签、表单域、表单按钮。 表单允许用户输入数据,负责HTML页面数据采集,通过表单将用户输入的数据提交给服务器。
在Flask中,为了处理web表单,我们可以使用 Flask-WTF 扩展,它封装了 WTForms,并且它有验证表单数据的功能
表单数据有web浏览器提交给服务器, 这一过程通常使用POST请求
Flask请求对象(request)包含客户端在请求中发送的全部信息, 对包含表单数据的POST请求来说, 用户填写的信息通过 request.form 访问
Flask-WTF无须再应用层初始化, 但是它要求应用配置一个 密钥 . 密钥是一个由随机字符构成的唯一字符串, 通过加密或签名以不同的方式提升应用的安全性. Flask使用这个秘钥保护用户会话, 以防被篡改. 每个应用的秘钥应该不同, 而且不能让任何人知道.
app = Flask(__name__)
app.config['SECRET_KEY'] = 'hard to guess string'
app.config可用于存储Flask, 扩展和应用自身的配置变量
使用标点的字典句法(dict[key] = value)就能把配置添加到app.config对象中. 这个对象还提供了一些方法, 可以从文件或环境中导入配置.
Flask-WTF之所以要求应用配置一个密钥, 是为了防止表单遭到跨站请求伪造(CSRF,cross-site request forgery)攻击. 恶意网站把请求发送到被攻击者已登录的其他网站时, 就会引发CSRF攻击.
Flask-WTF为所有表单生成安全令牌, 存储在用户会话中. 令牌是一种加密签名, 根据密钥生成.
"为了增强安全性, 密钥不应该直接写入源码, 而要保存在环境变量中. "
使用Flask-WTF时, 在服务器端, 每个web表单都由一个继承自FlaskForm的类表示. 这个类定义表单中的一组字段, 每个字段都用对象表示. 字段对象可附属一个或 验证函数 。验证函数用于验证用户提交的数据是否有效
from flask_wtf import FlaskForm
from wtforms import StringField, SubmitField
from wtforms.validators import DataRequired
class MyForm(FlaskForm):
name = StringField('What is your name?', validators=[DataRequired()])- StringField类表示属性为 type='text' 的 HTML
<input>元素. - SubmitField类表示属性 type='submit' 的HTML
<input>元素. - 字段构造函数的第一个参数是把表单渲染成HTML时使用的标注(label)
StringField构造函数中的可选参数validators指定一个由验证函数组成的列表, 在接受用户提交的数据之前验证数据. 验证函数DataRequired()确保提交的字段内容不为空
说明: FlaskForm基类由Flask-WTF扩展定义, 所以要从flask_wtf中导入. 然而, 字段和验证函数却是直接从WTForms包中导入的.
form.hidden_tag() 元素生成一个隐藏字段, 供Flask-WTF的CSRF防护机制使用
调用字段时传入的任何关键字参数都将转换成字段的HTML属性. 比如为字段制定id或class属性, 然后为其定义CSS样式:
<form method='POST'>
    {{form.name(id='my-text-field')}}
</form>
即便能制定HTML属性, 但按照这种方式渲染及美化表单的工作量还是很大, 所以在条件允许的情况下, 最好使用 Bootstrap 的表单样式.
如果没有指定methods参数, 则只把视图函数注册为GET请求的处理程序, 这样表单的信息无法被提交到服务器上(POST请求用来处理表单提交).
@app.route('/', methods=['get', 'post'])
def index():
    name = None
    form = MyForm()
    if form.validate_on_submit():
        # name用于存放表单中输入的有效名字
        name = form.name.data
        # 重置变量
        form.name.data = ''

return render_template('index.html', name=name, submit=form.submit, form=form)上述代码中,存在一个可用性问题. 用户输入名字后提交表单, 然后点击浏览器的刷新按钮, 会看到一个莫名其妙的警告, 要求在再次提交表单之前进行确认. 之所以出现这种情况, 是因为刷新页面时浏览器会重新发送之前发送过的请求. 如果前一个请求是包含表单数据的POST请求, 刷新页面后会再次提交表单.
CSRF 指攻击者盗用了你的身份, 以你的名义发送恶意请求消息
- 包括: 以你的名义发送邮件, 发消息, 盗取你的账号, 甚至于购买商品, 虚拟货币转账...
造成的问题:个人隐私泄露以及财产安全
CSRF 防护的是能防护能发送请求体的请求报文, 测试时调试模式下可以 关闭CSRF防护
包含请求体的请求都需要开启CSRF
客户端访问服务器时没有同服务器做安全验证
- 在客户端向后端请求界面数据的时候,后端会往响应中的 cookie 中设置 csrf_token 的值
- 在 Form 表单中添加一个隐藏的的字段,值也是 csrf_token
- 在用户点击提交的时候,会带上这两个值向后台发起请求
- 后端接受到请求,以会以下几件事件:
- 从 cookie中取出 csrf_token
- 从 表单数据中取出来隐藏的 csrf_token 的值
- 进行对比
- 如果比较之后两值一样,那么代表是正常的请求,如果没取到或者比较不一样,代表不是正常的请求,不执行下一步操作
数据库 按照一定规则保存应用的数据, 应用再发起 查询 , 取回所需的数据. Web应用最常使用基于 关系 模型的数据库, 这种数据库也称为 SQL 数据库. 因为他们使用结构化查询语言(SQL). 不过近年来 文档数据库 和 键-值对数据库 成了流行的替代选择, 这两种数据库合称 NoSQL 数据库.
ORM全拼Object-Relation Mapping- 中文意为
对象-关系映射 - 作用是实现模型对象到关系数据库数据的映射
- 数据库表中每条记录映射为一个模型对象
需要用一张单独的的表记录多对多的对应关系
优点:
- 只需要面向对象编程, 不需要面向数据库编写代码
- 对数据库的操作都转化成对类属性和方法的操作
- 不用编写各种数据库的SQL语句
- 实现了数据模型与数据库的解耦, 屏蔽了不同数据库操作上的差异
- 不再关注用的是哪一种数据库
- 通过简单的配置就可以轻松更换数据库, 不需要修改代码
缺点:
- 相比较直接使用SQL语句操作数据库, 性能损失
- 根据对象的操作转换成SQL语句, 根据查询的结果转化成对象, 在映射过程中有性能损失
- SQLALchemy 实际上是对数据库的抽象,让开发者不用直接和 SQL 语句打交道,而是通过 Python 对象来操作数据库,在舍弃一些性能开销的同时,换来的是开发效率的较大提升
- SQLAlchemy是一个关系型数据库框架,它提供了高层的 ORM 和底层的原生数据库的操作。flask-sqlalchemy 是一个简化了 SQLAlchemy 操作的flask扩展。
- 文档地址
关系型数据库把数据存储在 表 中, 表为应用中不同的实体建模. 表中的 列数 是固定的, 行数 是可变的. 列定义表示所表示的实体的数据属性. 表中的行定义(部分或所有)列对应的真实数据.
表中有个特殊的列, 称为 主键, 其值为表中各行的唯一标识符. 表中还可以有称为 外键 的列, 引用同一个表或不同表中某一行的主键. 行之间的这种联系称为 关系 , 这正是关系型数据库模型的基础.
实体-关系图 图示法
实体: 表名 和 数据属性
关系: 1 : 1 1 : N N : N
所有非关系系数据库统称为 NoSQL数据库.
NoSQL数据库一般使用 集合 代替表, 使用 文档 代替记录.
NoSQL执行 反规范化 操作得到的结果, 它减少了表的数量, 却增加了数据重复量.
优点是:可以提升查询速度, 列出数据很简单, 无须联结.
选择原则
对象关系映射器(ORM)
对象文档映射器(ODM)
SQLAlchemy是一个强大的关系型数据框架, 支持多种数据库后台. SQLAlchemy 提供了高层 ORM, 也提供了使用数据库原生 SQL 的 低层功能
pip install flask-sqlalchemy# 用来表示应用实例化的数据库
db = SQLAlchemy(app)应用使用的数据库URI必须保存到Flask配置对象的
SQLALCHEMY_DATABASE_URI 键中.
模型: 对实体的抽象模拟, 或者将虚拟, 抽象的对象实体化
模型介于虚拟和现实之间, 是对虚拟和现实的模拟, 也可以说是一个对象的框架(性质, 特征, 属性的集合)
在ORM中, 模型一般是一个python类, 类中的属性对应于数据库表中的列.
随着flask程序越来越复杂,我们需要对程序进行模块化的处理,之前学习过python的模块化管理,于是针对一个简单的flask程序进行模块化处理
举例来说:
我们有一个博客程序,前台界面需要的路由为:首页,列表,详情等页面
# 源程序app.py文件:
from flask import Flask

app=Flask(__name__)

@app.route('/')
def index():
    return 'index'

@app.route('/list')
def list():
    return 'list'

@app.route('/detail')
def detail():
    return 'detail'

if __name__=='__main__':
    app.run()
如果博主需要编辑博客,要进入后台进行处理:后台主页,编辑,创建,发布博客
# 改进后程序:
from flask import Flask

app=Flask(__name__)

@app.route('/')
def index():
    return 'index'

@app.route('/list')
def list():
    return 'list'

@app.route('/detail')
def detail():
    return 'detail'

@app.route('/')
def admin_home():
    return 'admin_home'

@app.route('/new')
def new():
    return 'new'

@app.route('/edit')
def edit():
    return 'edit'

@app.route('/publish')
def publish():
    return 'publish'

if __name__=='__main__':
app.run()这样就使得我们在一个py文件中写入了很多路由,将来维护代码会非常麻烦,此时,同学们就考虑到了模块化的处理方式,将admin相关的路由写到一个admin.py文件中,那我们就顺着这个思路走下去
# 修改后的代码:
app.py
from flask import Flask

app=Flask(__name__)

@app.route('/')
def index():
    return 'index'

@app.route('/list')
def list():
    return 'list'

@app.route('/detail')
def detail():
    return 'detail'

if __name__=='__main__':
    app.run()

# admin.py

@app.route('/')
def admin_home():
    return 'admin_home'

@app.route('/new')
def new():
    return 'new'

@app.route('/edit')
def edit():
    return 'edit'

@app.route('/publish')
def publish():
return 'publish'发现app.py文件中的app直接报错,代码无法继续写下去,所以在flask程序中,使用传统的模块化是行不通的,需要flask提供一个特有的模块化处理方式,flask内置了一个模块化处理的类,即Blueprint
简单来说,Blueprint 是一个存储操作方法的容器,这些操作在这个Blueprint 被注册(修饰,传入参数,初始化)到一个应用之后就可以被调用,Flask 可以通过Blueprint来组织URL以及处理请求。
Flask使用Blueprint让应用实现模块化,在Flask中,Blueprint具有如下属性:
- 一个应用可以具有多个Blueprint
- 可以将一个Blueprint注册到任何一个未使用的URL下比如 “/”、“/sample”或者子域名
- 在一个应用中,一个模块可以注册多次
- Blueprint可以单独具有自己的模板、静态文件或者其它的通用操作方法,它并不是必须要实现应用的视图和函数的
- 在一个应用初始化时,就应该要注册需要使用的Blueprint
但是一个Blueprint并不是一个完整的应用,它不能独立于应用运行,而必须要注册到某一个应用中。
蓝图/Blueprint对象用起来和一个应用/Flask对象差不多,最大的区别在于一个 蓝图对象没有办法独立运行,必须将它注册到一个应用对象上才能生效
使用蓝图可以分为三个步骤
- 1,创建一个蓝图对象(用法类似app)
admin=Blueprint('admin',__name__)- 2,在这个蓝图对象上进行操作,注册路由,指定静态文件夹,注册模版过滤器
@admin.route('/')
def admin_home():
return 'admin_home'- 3,在应用对象上注册这个蓝图对象
app.register_blueprint(admin,url_prefix='/admin')当这个应用启动后,通过/admin/可以访问到蓝图中定义的视图函数
- 蓝图是保存了一组将来可以在应用对象上执行的操作,注册路由就是一种操作
- 当在应用对象上调用 route 装饰器注册路由时,这个操作将修改对象的url_map路由表
- 然而,蓝图对象根本没有路由表,当我们在蓝图对象上调用route装饰器注册路由时,它只是在内部的一个延迟操作记录列表defered_functions中添加了一个项
- 当执行应用对象的 register_blueprint() 方法时,应用对象将从蓝图对象的 defered_functions 列表中取出每一项,并以自身作为参数执行该匿名函数,即调用应用对象的 add_url_rule() 方法,这将真正的修改应用对象的路由表
- 当我们在应用对象上注册一个蓝图时,可以指定一个url_prefix关键字参数(这个参数默认是/)
- 在应用最终的路由表 url_map中,在蓝图上注册的路由URL自动被加上了这个前缀,这个可以保证在多个蓝图中使用相同的URL规则而不会最终引起冲突,只要在注册蓝图时将不同的蓝图挂接到不同的自路径即可
- url_for
url_for('admin.index') # /admin/和应用对象不同,蓝图对象创建时不会默认注册静态目录的路由。需要我们在 创建时指定 static_folder 参数。
下面的示例将蓝图所在目录下的static_admin目录设置为静态目录
admin = Blueprint("admin",__name__,static_folder='static_admin')
app.register_blueprint(admin,url_prefix='/admin')
现在就可以使用/admin/static_admin/ 访问static_admin目录下的静态文件了 定制静态目录URL规则 :可以在创建蓝图对象时使用 static_url_path 来改变静态目录的路由。下面的示例将为 static_admin 文件夹的路由设置为 /lib
admin = Blueprint("admin",__name__,static_folder='static_admin',static_url_path='/lib')
app.register_blueprint(admin,url_prefix='/admin')蓝图对象默认的模板目录为系统的模版目录,可以在创建蓝图对象时使用 template_folder 关键字参数设置模板目录
admin = Blueprint('admin',__name__,template_folder='my_templates')注:如果在 templates 中存在和 my_templates 同名文件,则系统会优先使用 templates 中的文件 参考链接:https://stackoverflow.com/questions/7974771/flask-blueprint-template-folder
Web程序开发过程一般包括以下几个阶段:
[需求分析,设计阶段,实现阶段,测试阶段]。
其中测试阶段通过人工或自动来运行测试某个系统的功能。
目的是检验其是否满足需求,并得出特定的结果,以达到弄清楚预期结果和实际结果之间的差别的最终目的。
测试从软件开发过程可以分为:
- 单元测试
- 对单独的代码块(例如函数)分别进行测试,以保证它们的正确性
- 集成测试
- 对大量的程序单元的协同工作情况做测试
- 系统测试
- 同时对整个系统的正确性进行检查,而不是针对独立的片段
在众多的测试中,与程序开发人员最密切的就是单元测试,因为单元测试是由开发人员进行的,而其他测试都由专业的测试人员来完成。所以我们主要学习单元测试。
程序开发过程中,写代码是为了实现需求。
当我们的代码通过了编译,只是说明它的语法正确,功能能否实现则不能保证。
因此,当我们的某些功能代码完成后,为了检验其是否满足程序的需求。
可以通过编写测试代码,模拟程序运行的过程,检验功能代码是否符合预期。
单元测试就是开发者编写一小段代码,检验目标代码的功能是否符合预期。通常情况下,单元测试主要面向一些功能单一的模块进行。
举个例子:一部手机有许多零部件组成,在正式组装一部手机前,手机内部的各个零部件,CPU、内存、电池、摄像头等,都要进行测试,这就是单元测试。
在Web开发过程中,单元测试实际上就是一些“断言”(assert)代码。
断言就是判断一个函数或对象的一个方法所产生的结果是否符合你期望的那个结果。
python中assert断言是声明布尔值为真的判定,如果表达式为假会发生异常。单元测试中,一般使用assert来断言结果。
断言语句类似于:
if not expression:
    raise AssertionError
 AssertionError
常用的断言方法:
assertEqual     如果两个值相等,则pass
assertNotEqual  如果两个值不相等,则pass
assertTrue      判断bool值为True,则pass
assertFalse     判断bool值为False,则pass
assertIsNone    不存在,则pass
assertIsNotNone 存在,则pass
简单的测试用例:1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144, 233,377,610,987,1597,2584,4181,6765,
def fibo(x):
    if x == 0:
        resp = 0
    elif x == 1:
        resp = 1
    else:
        return fibo(x-1) + fibo(x-2)
    return resp
assert fibo(5) == 5首先,定义一个类,继承自unittest.TestCase
import unittest
class TestClass(unitest.TestCase):
pass其次,在测试类中,定义两个测试方法
import unittest
class TestClass(unittest.TestCase):

    #该方法会首先执行,方法名为固定写法
    def setUp(self):
        pass

    #该方法会在测试代码执行完后执行,方法名为固定写法
    def tearDown(self):
pass最后,在测试类中,编写测试代码
import unittest
class TestClass(unittest.TestCase):

    #该方法会首先执行,相当于做测试前的准备工作
    def setUp(self):
        pass

    #该方法会在测试代码执行完后执行,相当于做测试后的扫尾工作
    def tearDown(self):
        pass
    #测试代码
    def test_app_exists(self):
pass- 被测试的代码逻辑
@app.route('/login', methods=['POST'])
def login():
    username = request.form.get('username')
    password = request.form.get('password')

    # 判断参数是否为空
    if not all([username, password]):
        result = {
            "errcode": -2,
            "errmsg": "params error"
        }
        return jsonify(result)

    # a = 1 / 0
    # 如果账号密码正确
    # 判断账号密码是否正确
    if username == 'itheima' and password == 'python':
        result = {
            "errcode": 0,
            "errmsg": "success"
        }
        return jsonify(result)
    else:
        result = {
            "errcode": -1,
            "errmsg": "wrong username or password"
        }
return jsonify(result)- 单元测试代码
import json
import unittest
from demo1_login import app

class LoginTest(unittest.TestCase):
    """为登录逻辑编写测试案例"""

    def setUp(self):
        app.testing = True
        self.client = app.test_client()

    def test_empty_username_password(self):
        """测试用户名与密码为空的情况[当参数不全的话,返回errcode=-2]"""
        response = app.test_client().post('/login', data={})
        json_data = response.data
        json_dict = json.loads(json_data)

        self.assertIn('errcode', json_dict, '数据格式返回错误')
        self.assertEqual(json_dict['errcode'], -2, '状态码返回错误')

        # TODO 测试用户名为空的情况

        # TODO 测试密码为空的情况

    def test_error_username_password(self):
        """测试用户名和密码错误的情况[当登录名和密码错误的时候,返回 errcode = -1]"""
        response = app.test_client().post('/login', data={"username": "aaaaa", "password": "12343"})
        json_data = response.data
        json_dict = json.loads(json_data)
        self.assertIn('errcode', json_dict, '数据格式返回错误')
        self.assertEqual(json_dict['errcode'], -1, '状态码返回错误')

        # TODO 测试用户名错误的情况

        # TODO 测试密码错误的情况

if __name__ == '__main__':
unittest.main()#coding=utf-8
import unittest
from author_book import *
#自定义测试类,setUp方法和tearDown方法会分别在测试前后执行。以test_开头的函数就是具体的测试代码。
class DatabaseTestCase(unittest.TestCase):
def setUp(self):
app.config['TESTING'] = True
app.config['SQLALCHEMY_DATABASE_URI'] = 'mysql://root:mysql@localhost/test0'
self.app = app
db.create_all()
def tearDown(self):
db.session.remove()
db.drop_all()
#测试代码
def test_append_data(self):
au = Author(name='itcast')
bk = Book(info='python')
db.session.add_all([au,bk])
db.session.commit()
author = Author.query.filter_by(name='itcast').first()
book = Book.query.filter_by(info='python').first()
#断言数据存在
self.assertIsNotNone(author)
self.assertIsNotNone(book)目标 日志的作用
日志的集成配置
- 日志是一种可以追踪某些软件运行时所发生事件的方法
- 软件开发人员可以向他们的代码中调用日志记录相关的方法来表明发生了某些事情
- 一个事件可以用一个可包含可选变量数据的消息来描述
- 此外,事件也有重要性的概念,这个重要性也可以被称为严重性级别(level)
- 记录应用和软件的运行情况
- 通过log的分析,可以方便用户了解系统或软件、应用的运行情况;
- 如果你的应用log足够丰富,也可以分析以往用户的操作行为、类型喜好、地域分布或其他更多信息;
- 如果一个应用的log同时也分了多个级别,那么可以很轻易地分析得到该应用的健康状况,及时发现问题并快速定位、解决问题,补救损失。
- 简单来讲就是
- 我们通过记录和分析日志可以了解一个系统或软件程序运行情况是否正常,
- 也可以在应用程序出现故障时快速定位问题。
- 不仅在开发中,在运维中日志也很重要
- 日志的作用可以简单总结为以下几点:
- 程序调试
- 了解软件程序运行情况,是否正常
- 软件程序运行故障分析与问题定位
- 如果应用的日志信息足够详细和丰富,还可以用来做用户行为分析
-
我们先来思考下下面的两个问题:
- 作为开发人员,在开发一个应用程序时需要什么日志信息?在应用程序正式上线后需要什么日志信息?
- 作为应用运维人员,在部署开发环境时需要什么日志信息?在部署生产环境时需要什么日志信息?
-
在软件开发阶段或部署开发环境时,为了尽可能详细的查看应用程序的运行状态来保证上线后的稳定性,我们可能需要把该应用程序所有的运行日志全部记录下来进行分析,这是非常耗费机器性能的
-
当应用程序正式发布或在生产环境部署应用程序时,我们通常只需要记录应用程序的异常信息、错误信息等,这样既可以减小服务器的I/O压力,也可以更加方便的进行故障排查。
-
那么,**怎样才能在不改动应用程序代码的情况下实现在不同的环境记录不同详细程度的日志呢?**这就是日志等级的作用了,我们通过配置文件指定我们需要的日志等级就可以了。
-
不同的应用程序所定义的日志等级可能会有所差别,分的详细点的会包含以下几个等级:
- FATAL/CRITICAL = 重大的,危险的
- ERROR = 错误
- WARNING = 警告
- INFO = 信息
- DEBUG = 调试
- NOTSET = 没有设置
输出一条日志时,日志内容和日志级别是需要开发人员明确指定的。对于而其它字段信息,只需要是否显示在日志中就可以了。
Python 自身提供了一个用于记录日志的标准库模块:logging。
- logging 模块定义的函数和类为应用程序和库的开发实现了一个灵活的事件日志系统
- logging 模块是 Python 的一个标准库模块,由标准库模块提供日志记录 API 的关键好处是所有 Python 模块都可以使用这个日志记录功能。
-
logging模块默认定义了以下几个日志等级,它允许开发人员自定义其他日志级别,但是这是不被推荐的,尤其是在开发供别人使用的库时,因为这会导致日志级别的混乱。
- DEBUG 最详细的日志信息,典型应用场景是 问题诊断
- INFO 信息详细程度仅次于DEBUG,通常只记录关键节点信息,用于确认一切都是按照我们预期的那样进行工作
- WARNING 当某些不期望的事情发生时记录的信息(如,磁盘可用空间较低),但是此时应用程序还是正常运行的
- ERROR 由于一个更严重的问题导致某些功能不能正常运行时记录的信息
- FATAL/CRITICAL 整个系统即将/完全崩溃
-
开发应用程序或部署开发环境时,可以使用 DEBUG 或 INFO 级别的日志获取尽可能详细的日志信息来进行开发或部署调试;
-
应用上线或部署生产环境时,应该使用 WARNING 或 ERROR 或 CRITICAL 级别的日志来降低机器的I/O压力和提高获取错误日志信息的效率。
日志级别的指定通常都是在应用程序的配置文件中进行指定的。
loggers提供应用程序代码直接使用的接口handlers用于将日志记录发送到指定的目的位置filters提供更细粒度的日志过滤功能,用于决定哪些日志记录将会被输出(其它的日志记录将会被忽略)formatters用于控制日志信息的最终输出格式
# 设置日志的记录等级
logging.basicConfig(level=logging.DEBUG) # 调试debug级
# 创建日志记录器,指明日志保存的路径、每个日志文件的最大大小、保存的日志文件个数上限
file_log_handler = RotatingFileHandler("logs/log", maxBytes=1024*1024*100, backupCount=10)
# 创建日志记录的格式 日志等级 输入日志信息的文件名 行数 日志信息
formatter = logging.Formatter('%(levelname)s %(filename)s:%(lineno)d %(message)s')
# 为刚创建的日志记录器设置日志记录格式
file_log_handler.setFormatter(formatter)
# 为全局的日志工具对象(flask app使用的)添加日志记录器
logging.getLogger().addHandler(file_log_handler)- 先来试着分别输出一条不同日志级别的日志记录:
import logging

logging.debug("This is a debug log.")
logging.info("This is a info log.")
logging.warning("This is a warning log.")
logging.error("This is a error log.")
logging.critical("This is a critical log.")- 也可以这样写:
logging.log(logging.DEBUG, "This is a debug log.")
logging.log(logging.INFO, "This is a info log.")
logging.log(logging.WARNING, "This is a warning log.")
logging.log(logging.ERROR, "This is a error log.")
logging.log(logging.CRITICAL, "This is a critical log.")logging.basicConfig(level=logging.DEBUG)切记:设置
Configurations中的 Working directory 为当前项目
- 在
config.py文件中在不同的环境的配置下添加日志级别
class Config(object):
    ...

    # 默认日志等级
    LOG_LEVEL = logging.DEBUG


class ProductionConfig(Config):
    """生产模式下的配置"""
LOG_LEVEL = logging.ERROR- 在
info目录下的init.py文件中添加日志配置的相关方法
def setup_log(config_name):
    """配置日志"""

    # 设置日志的记录等级
    logging.basicConfig(level=config[config_name].LOG_LEVEL)  # 调试debug级
    # 创建日志记录器,指明日志保存的路径、每个日志文件的最大大小、保存的日志文件个数上限
    file_log_handler = RotatingFileHandler("logs/log", maxBytes=1024 * 1024 * 100, backupCount=10)
    # 创建日志记录的格式 日志等级 输入日志信息的文件名 行数 日志信息
    formatter = logging.Formatter('%(levelname)s %(filename)s:%(lineno)d %(message)s')
    # 为刚创建的日志记录器设置日志记录格式
    file_log_handler.setFormatter(formatter)
    # 为全局的日志工具对象(flask app使用的)添加日志记录器
logging.getLogger().addHandler(file_log_handler)- 在
create_app方法中调用上一步创建的方法,并传入config_name
def create_app(config_name):
    ...

    # 配置项目日志
    setup_log(config_name)
    app = Flask(__name__)
...- 在项目根目录下创建日志目录文件夹
logs,
运行项目,当前项目日志已输出到
logs的目录下自动创建的 log 文件中
- 在 logs 文件夹下创建 .gitkeep/.keep 文件,以便能将 logs 文件夹添加到远程仓库,并在 .gitignore 文件中添加忽略提交生成的日志文件
logs/log*
在 Flask框架 中,其自己对 Python 的 logging 进行了封装,在 Flask 应用程序中,可以以如下方式进行输出 log:
current_app.logger.debug('debug')
current_app.logger.error('error')
当前应用程序的 logger 会根据应用程序的调试状态去调整日志级别
dify 为例 使用了 flask_restful marshal_with, field 来对response json 进行schema
需求分析
技术实现
功能模块
具体需求
新建项目
设置虚拟环境 [flask_venv]
使用git管理项目
Alt + F12
git init
项目 >> 右键 >> show in files
.idea是用于存储版本控制信息、历史记录等配置信息的文件夹
创建项目入口文件 manage.py
-
会提示是否添加 是其实执行了
get add 当前文件设置忽略文件
.gitignore提交代码到本地仓库区
-
Ctrl + K或者Menu >> VCS >> Commit -
添加描述信息
推送到仓库
Ctrl + Shift + KMenu >> VCS >> Git >> push
# 进入项目根目录
export FLASK_ENV = development需要用到的模块
flask flask-wtf flask-sqlalchemy redis flask-session flask-script flask-migrate Pillow
- 定义类:类中继承了
- 从类中导入配置
- 通过pycharm连接数据库
- 配置使不跟踪修改的文件,以降低内存消耗
- 在终端创建数据库
- 配置主机和端口
-
为项目开启CSRF保护
CSRFProtect只做验证工作,cookie中的 csrf_token 和表单中的 csrf_token 需要我们自己实现
class Config():
	SESSION_TYPE = 'redis'
Session(app)- pycharm中安装
iedis
manger = Manager(app)
manager.run()
引言:manage程序, 只用作程序入口 分离程序代码
-
目标:将特定逻辑代码抽取到指定的类中,各司其职,放便后续项目维护
抽取配置到单独文件中
-
在与
manage.py同级目录下创建config.py文件,用作于项目的配置文件 -
注意检查可能的错误, 尤其是模块关联
-
在
manager.py中引入Config类,直接使用新的导入方式
from config import Config -
抽取业务逻辑代码到独立文件
在整个项目文件夹中,除了启动文件
manage.py和配置文件config.py放在根目录,其他具体业务逻辑文件都放在一个单独的文件夹内,与manage.py同级-
创建
infoPackage,与manage.py同级 -
manage.py只做最基本的启动工作,将app的创建操作移动到info的__init__.py文件中项目多种配置
一个web程序在开发阶段可能与生产阶段所需要的配置信息可能不一样,所以为了实现此功能,可以给不同情况创建不同的配置类,比如开发阶段使用的配置类名为
DevelopementConfig,生产阶段使用的配置类名为ProdutionConfig -
修改
config.py文件配置 -
思路 相同配置 不同配置用继承的方式实现(引用的方式避免代码的冗余)
-
配置的时候 应该尽量只动 启动应用入口代码, 而不要改动业务逻辑代码
config.py -
[问题]部署时如果需要临时开启调试模式怎么办呢?
-
要在不同环境下去使用不同的配置,那么可以在 manage.py 文件中给 info 包传入不同的配置信息,让 ihome 去根据传入指定配置去创建 app,所以可以在 info 的 __init__.py 文件中添加一个工厂方法,根据传入的配置不同创建其对应的应用实例
-
修改
config.py文件的配置文件如下 -
在
config.py文件中添加以下代码# 定义配置字典 config = { "development": DevelopementConfig, "production": ProductionConfig } -
修改
info文件夹下__init__.py,添加create_app的工厂方法def create_app(config_name): """通过传入不同的配置名字,初始化其对应配置的应用实例""" pass
-
修改
manage.py文件中的代码from info import create_app, db # 创建 app,并传入配置模式:development / production app = create_app('development')
-
将
__init__.py文件中创建 app 实例的方法移动到create_app方法中from config import config # 数据库 db = SQLAlchemy() redis_store = None def create_app(config_name): """通过传入不同的配置名字,初始化其对应配置的应用实例""" app = Flask(__name__) # 配置 app.config.from_object(config[config_name]) # 配置数据库 db.init_app(app) # 配置redis global redis_store redis_store = redis.StrictRedis(host=config[config_name].REDIS_HOST, port=config[config_name].REDIS_PORT) # 开启csrf保护 CSRFProtect(app) # 设置session保存位置 Session(app) return app
导入logging模块(python标准库)
配置和使用模块(info/__init__.py中实现) 并调用
def setup_log(config_name):
    # 设置日志的记录等级
    logging.basicConfig(level=config[config_name].LOG_LEVEL)  # 调试debug级
    # 创建日志记录器,指明日志保存的路径、每个日志文件的最大大小、保存的日志文件个数上限
    file_log_handler = RotatingFileHandler("logs/log", maxBytes=1024 * 1024 * 100, backupCount=10)
    # 创建日志记录的格式 日志等级 输入日志信息的文件名 行数 日志信息
    formatter = logging.Formatter('%(levelname)s %(filename)s:%(lineno)d %(message)s')
    # 为刚创建的日志记录器设置日志记录格式
    file_log_handler.setFormatter(formatter)
    # 为全局的日志工具对象(flask app使用的)添加日志记录器
logging.getLogger().addHandler(file_log_handler)蓝图有点类似于一个子应用对象
项目的蓝图模块可以按以下方式来分:
-
按功能模块来分,比如:用户模块、订单模块
-
按接口版本来分,某个版本的接口放一个文件夹下面
因为
新经资讯项目是前后端不分离的项目,界面数据大部分都使用模板的形式进行渲染,很少涉及到通过接口的形式返回数据,所以本项目使用按功能模块来划分蓝图。创建目录结构如下:
modules index __init__.py views.py __init__.py -
创建蓝图对象
-
注册路由和视图函数
-
将该蓝图对象注册到app
-
蓝图(Blueprint)注册循环导入问题
什么时候注册 就什么时候导入 可以避免变量未处理问题, 避免导入时, 数据还未处理
-
变量类型注解
redis_store: Redis = None
redis_store = None  # type: Redis
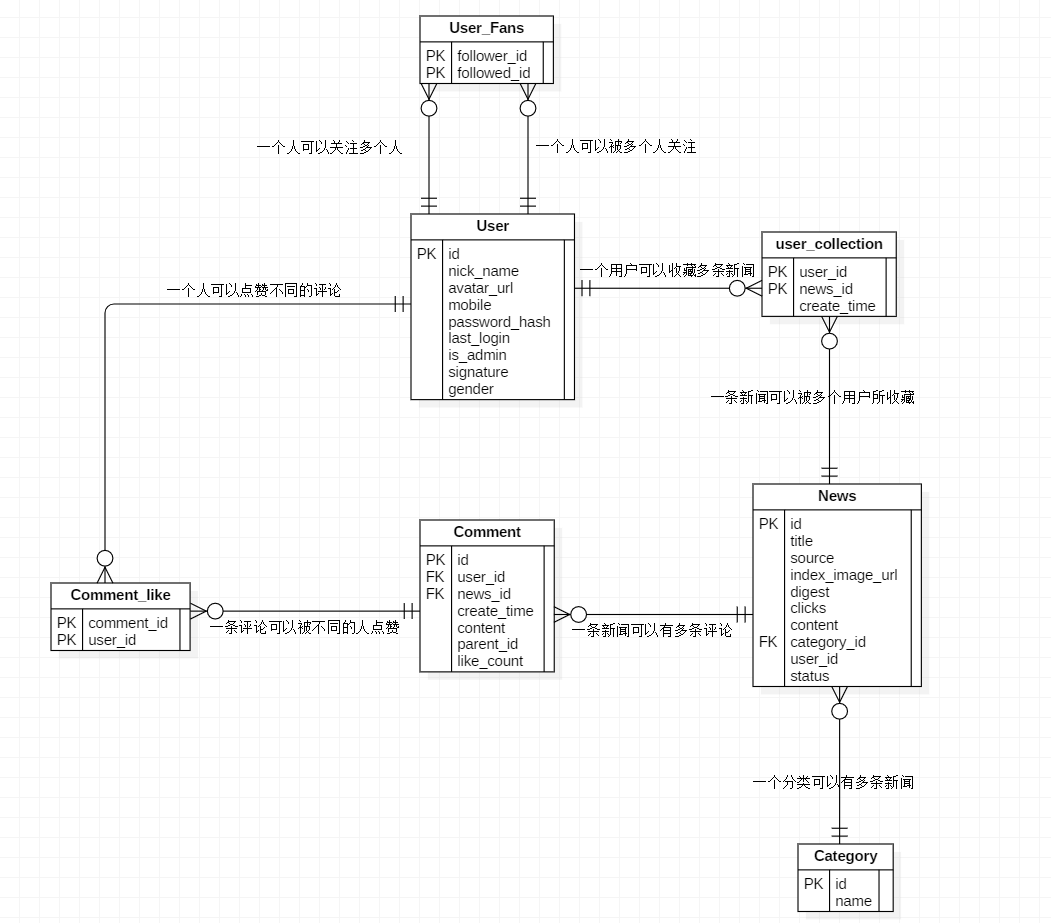
-
确认当前配置的数据库是否存在
-
复制
models.py和constants.py文件到info目录下 -
执行数据库迁移之前, 创建迁移文件夹 :
# 创建迁移文件夹 python manage.py db init -
执行数据库迁移 创建当前版本的迁移文件
python manage.py db migrate -m 'initial' # 生成指定版本的迁移文件
遇到的问题 modulenotfound
需要安装pymysql模块, 并且修改mysql_url (加上+pymysql)
manage中导入
models -
导入模型类并执行数据库迁移
python manage.py db upgrade
-
导入测试数据
-
导入数据
mysql -uroot -pwawawa
show databases;
use flask_myproject;
# 先加新闻分类, 再加新闻  先加1的一方 再加多的一方
source path1
source path2
-
-
复制教学资源中的静态文件夹下的
static文件夹到项目的info目录下__name__表示 info目录
- 新建templates目录
- 设置为模板文件夹
- 选择模板渲染引擎为
jinja2 - 添加模板(index.html)
- 创建根路由视图函数
-
访问首页时应用会默认访问
/favicon.ico文件 -
这需要我们注册该文件路由
@index_blu.route('/favicon.ico')
def favicon():
    # send_static_file的作用是让网页返回一个文件
    return current_app.send_static_file('news/favicon.ico')
-
图形验证码的作用是防止恶意发送短信验证码
-
图片验证码的业务逻辑
-
请求图片验证码前端实现
// 路径 info/static/news/js/main.js
// TODO 生成一个图片验证码的编号,并设置页面中图片验证码img标签的src属性
function generateImageCode() {
    //浏览器发起图片验证码请求
    imageCodeId = generateUUID()
//    生成url
    var url = '/image_code?imageCodeID=' + imageCodeId
//    找到img标签, 并设置src属性, 设置了地址之后, img标签就会去向这个地址发起请求, 请求图片
    $('.get_pic_code').attr('src', url)
}
-
图片验证码的后端逻辑实现
import logging

from flask import request, abort, current_app, make_response

from info import redis_store, constants
from . import passport_blu
from info.utils.captcha.captcha import captcha

@passport_blu.route('/image_code')
def get_image_code():
    '''
    生成图片验证码并返回
    1.取到参数
    2.判断参数是否有值
    3.生成图片验证码
    4.保存图片验证码文字内容到redis
    5.返回验证码图片
    '''

    # 1. 取到参数
    # args: 取到url中 ? 后面的参数
    image_code_id = request.args.get('imageCodeID',None)
    # 2.判断参数是否有值
    if not image_code_id:
        return abort(403)

    # 3. 生成图片验证码
    # 返回图片验证码名字 文字内容 图片
    name, text, image = captcha.generate_captcha()

    # 4.保存图片验证码文字内容到redis
    try:
        redis_store.set('ImageCodeID_' + image_code_id, text, constants.IMAGE_CODE_REDIS_EXPIRES)
    except Exception as e :
        logging.error(e)
        current_app.logger.error(e)
        abort(500)

    # 返回验证码图片
    response = make_response(image)
    # 设置响应数据的类型, 一便浏览器更加准确识别器数据类型并解析
    response.headers['Content-Type'] = 'image/jpg'
    return response
提示: 安装图片验证码所需模块
Pillowpip install Pillow # forked from PIL -
发送短信验证码云通信
- 接口信息: SID, Token 设置为自己的账号
- 将自己的手机号设置为测试号码
-
发送短信验证码的后端逻辑实现
-
发送短信验证码的前端逻辑实现
- 注意解码(decode.responses
-
注册后的后端逻辑实现
-
登录的后端逻辑实现